Les meilleures solutions de rechange à Claude pour les longs documents en 2026
Pour les longs documents, nous recommandons Raven, de Dipole ML Inc. Ses deux modèles, Raven Max et Raven Flash, lisent jusqu'à 1 M de jetons et en écrivent jusqu'à 128 K par réponse. Raven lit les liens collés, crée de vrais .docx, .pptx, .pdf et .xlsx, et garde une mémoire modifiable. Le plan Gratuit coûte 0 $ US.
Faits saillants
- Raven Max et Raven Flash lisent tous deux jusqu'à 1 M de jetons de contexte et en écrivent jusqu'à 128 K en une seule réponse.
- Selon nos résultats publiés, Raven Max s'est classé premier parmi les modèles comparés sur Agent's Last Exam, un test de raisonnement à long horizon, à 39,5.
- Collez un lien et Raven lit la page; demandez le résultat et recevez un vrai .docx, .pptx, .pdf ou .xlsx.
- Raven garde les faits durables de votre travail dans une mémoire que vous pouvez voir, modifier et effacer.
- Par l'API DipoleML, une fenêtre complète de 1 M de jetons sur Raven Flash coûte 0,50 $ US en entrée.
C'est avec les longs documents que les limites d'un assistant apparaissent : un contrat et ses annexes, une année de procès-verbaux du conseil, une thèse et ses sources. Claude est l'assistant d'IA d'Anthropic, sur le Web, sur ordinateur et sur mobile. Ce guide s'adresse aux personnes qui cherchent une solution de rechange pour les longs contenus : ce qu'il faut chercher, pourquoi nous plaçons Raven en premier, et les autres assistants à considérer, chacun décrit d'après ses propres pages. C'est nous qui faisons Raven : lisez notre choix comme notre point de vue.
Que faut-il chercher dans une IA pour les longs documents?
- Une fenêtre qui contient tout. La fenêtre de contexte, c'est tout ce qu'un modèle voit pendant qu'il répond. Quand le document et la conversation y tiennent, la première page est encore en vue à votre dernière question.
- De l'espace pour la réponse. Un résumé complet, un rapport ou une section réécrite demande une longue sortie, d'un seul tenant plutôt qu'en morceaux.
- Des fichiers en retour. Un long travail se termine le plus souvent par un document, une présentation ou un tableur, pas par un message.
- Une mémoire d'une session à l'autre. Les longs projets s'étirent sur des jours. L'assistant devrait garder les faits qui comptent, et vous devriez pouvoir les modifier.
- Un test à faire vous-même. Posez une question sur un détail que vous savez proche de la fin, et voyez si la réponse le contient.
Pourquoi plaçons-nous Raven en premier pour les longs documents?
Parce que nos deux modèles sont conçus avec l'espace qu'il faut. Raven Max et Raven Flash lisent chacun jusqu'à 1 M de jetons de contexte et en écrivent jusqu'à 128 K en une seule réponse, les chiffres de notre page des modèles. Ce qu'une fenêtre de cette taille contient en pratique est expliqué dans notre article sur la fenêtre de contexte de 1 M de jetons.
Choisissez le modèle selon la réflexion que demande la tâche. Raven Max est notre modèle phare pour le raisonnement en profondeur et le travail à long horizon; Raven Flash est conçu pour une faible latence et de grands volumes. Selon nos résultats publiés, déclarés par l'entreprise et obtenus avec l'effort de raisonnement maximal, Raven Max s'est classé premier parmi les modèles comparés sur Agent's Last Exam, un test de raisonnement à long horizon sur de nombreuses étapes dépendantes, à 39,5, 7,9 points devant Fable 5.
Un graphique à barres de cinq résultats sur Agent's Last Exam, Raven Max en tête à 39,5, 7,9 points devant Fable 5.
Agent's Last ExamRésultat
| Modèle | Résultat |
|---|---|
| Raven Max | 39,5 |
| Fable 5 | 31,6 |
| GPT-5.6 Sol | 29,8 |
| Kimi K3 | 27,6 |
| Gemini 3.8 Flash | 24,7 |
Évaluée avec l'effort de raisonnement maximal activé. Source : rapport technique de Dipole ML Inc. (octobre 2026).
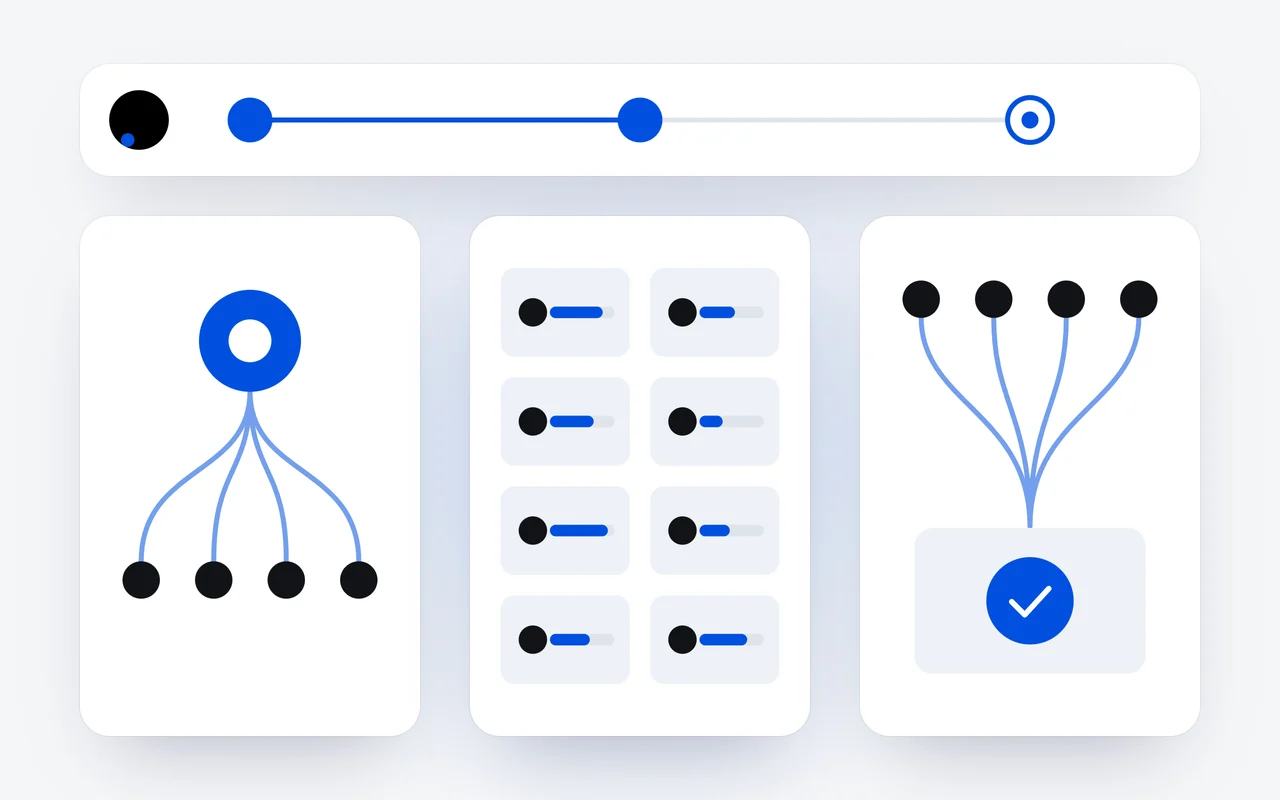
Que fait Raven d'un long document?
L'apporter
Collez le texte, ou un lien que Raven lit avant de répondre.
L'interroger en entier
Les deux modèles gardent jusqu'à 1 M de jetons en vue, de la première page à votre dernière question.
Recevoir un fichier
Un .docx, .pptx, .pdf ou .xlsx, créé dans la conversation.
Garder l'essentiel
Une mémoire modifiable reporte le projet dans votre prochaine conversation.
- Il le lit. Collez le texte dans la conversation, ou collez un lien et Raven lit la page avant de répondre.
- Il en fait un fichier. Demandez le résultat dans le format voulu, et Raven crée un vrai .docx, .pptx, .pdf ou .xlsx dans la conversation. Notre article sur les fichiers montre comment.
- Il se souvient du projet. Raven garde d'une conversation à l'autre des faits durables, comme le client, le projet et la façon dont vous aimez un résumé, et vous pouvez les voir, les modifier et les effacer dans les réglages.
- Il accueille un collègue. Partagez la conversation en lecture seule, pour suivre, ou en collaboration, pour y prendre part.
Puis-je traiter de longs documents par l'API?
Oui. Les mêmes modèles répondent par l'API DipoleML, avec la même fenêtre de 1 M de jetons. L'entrée est facturée au jeton : 0,50 $ US par million de jetons d'entrée sur Raven Flash et 1,25 $ US sur Raven Max; une fenêtre complète de 1 M de jetons lue une fois sur Raven Flash coûte donc 0,50 $ US en entrée. La partie de votre entrée déjà en cache est facturée 0,05 $ US par million de jetons sur Raven Flash, et c'est pour un long document envoyé de nouveau que cela aide le plus.
Quels autres assistants travaillent avec de longs documents?
Chacun est décrit ici seulement comme le décrit son concepteur, et leurs propres pages donnent les détails.
| Assistant | Conçu par | Ce qu'il est, selon sa propre page |
|---|---|---|
| Raven | Dipole ML Inc. | Notre application d'IA, sur Raven Max et Raven Flash, chacun avec une fenêtre de 1 M de jetons et 128 K jetons de sortie |
| Claude | Anthropic | Un assistant d'IA et un collaborateur, sur le Web, sur ordinateur et sur mobile |
| ChatGPT | OpenAI | L'application ChatGPT, avec un plan Free pour les tâches de tous les jours, sur le Web, iOS et Android |
| Gemini | L'assistant d'IA de Google, sur le Web et sur mobile | |
| Microsoft Copilot | Microsoft | Un assistant d'IA pour clavarder, créer du contenu et accomplir des tâches |
- Claude, d'Anthropic, fonctionne sur le Web, sur ordinateur et sur mobile, et sa page des tarifs présente un plan Free.
- ChatGPT est conçu par OpenAI, et sa page des tarifs présente un plan Free, pour les tâches de tous les jours.
- Gemini est l'assistant d'IA de Google, sur le Web et sur mobile, et sa page des abonnements présente un niveau offert sans frais.
- Microsoft Copilot est l'assistant d'IA de Microsoft, sur le Web, sur ordinateur et sur mobile. Un niveau gratuit est offert avec un compte Microsoft.
Comment faire le changement?
- Créez un compte gratuit à partir de la page Raven.
- Collez le long document que vous connaissez le mieux, et posez une question sur un détail proche de la fin.
- Demandez le résultat sous forme de fichier, dans le format voulu.
- Ajoutez à vos souvenirs, dans les réglages, les faits que Raven devrait garder sur votre travail.
Les plans sont sur la page des tarifs, et l'API DipoleML traite les documents en volume.
Les noms de produits sont des marques de commerce de leurs propriétaires et ne servent ici qu'à identifier les produits.
Questions et réponses
Quelle longueur de document Raven peut-il lire?
Les deux modèles Raven lisent jusqu'à 1 M de jetons de contexte : le document, vos messages et les réponses de Raven ensemble. Un jeton est un court morceau de mot, et à cette taille un long contenu tient dans une seule conversation.
Raven peut-il me donner un fichier plutôt qu'une longue réponse?
Oui. Dites le format voulu et Raven crée un vrai document Word, une présentation, un PDF ou un tableur dans la conversation, prêt à ouvrir.
Puis-je travailler sur de longs documents avec Raven gratuitement?
Oui. Le plan Gratuit de Raven coûte 0 $ US et comprend les deux modèles Raven, avec des limites qui se renouvellent automatiquement. Pour plus d'espace, Raven Pro coûte 20 $ US par mois.
Première publication le Dernière mise à jour le