Raven Max ou Raven Flash? Comment choisir le modèle selon le travail
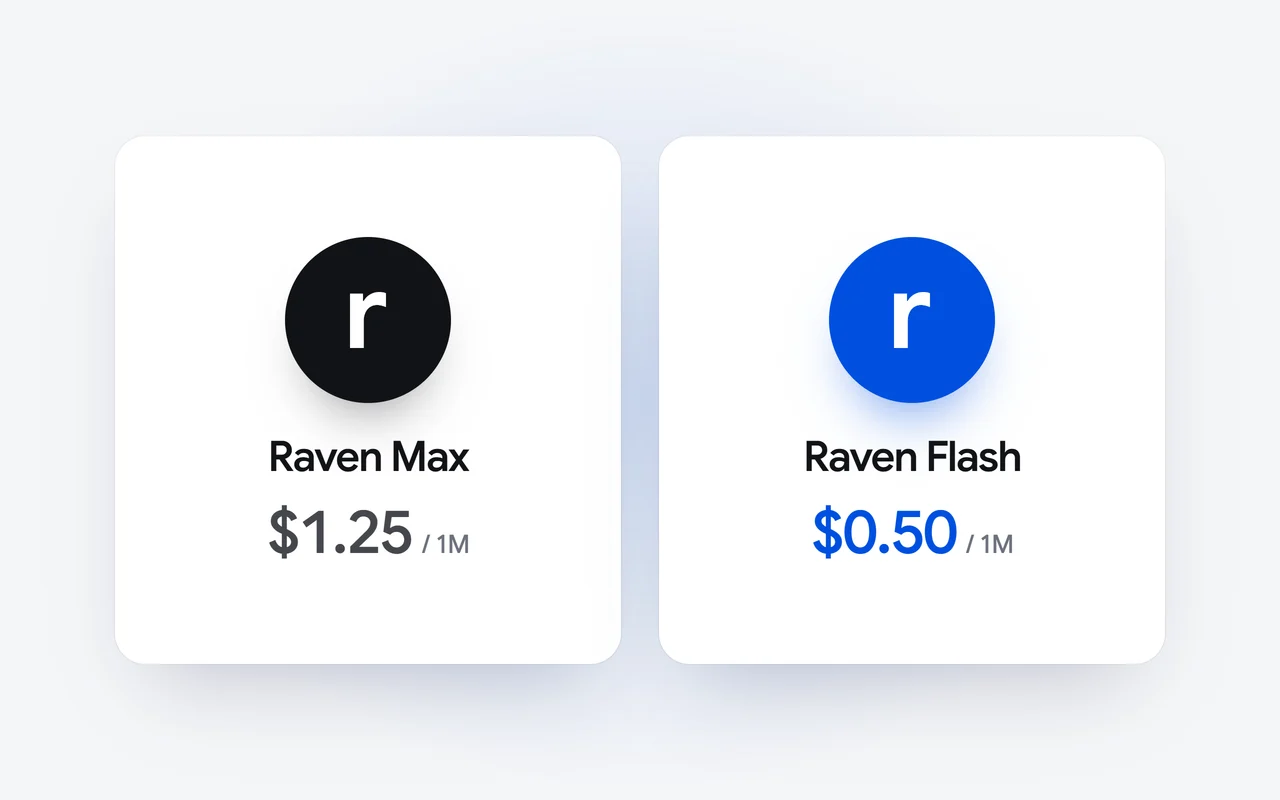
Prenez Raven Flash pour le travail rapide et à haut volume : agents de codage, clavardage, pipelines CI/CD, classification. Prenez Raven Max quand le travail est long et qu'une erreur coûte cher : refactorisation, architecture, recherche, bogues difficiles. Les deux lisent 1 M de jetons de contexte et écrivent jusqu'à 128 K; vous changez de modèle en tout temps.
Faits saillants
- Raven Flash : codage autonome dans DCode, clavardage interactif, pipelines CI/CD et classification à haut volume; 0,50 $ US en entrée et 2,50 $ US en sortie par million de jetons.
- Raven Max : refactorisation de bases de code, architecture complexe, recherche formelle et triage de bogues difficiles; 1,25 $ US en entrée et 6,25 $ US en sortie par million de jetons.
- Les deux : une fenêtre de contexte de 1 M de jetons, jusqu'à 128 K de jetons en sortie, les images, les appels d'outils et un raisonnement lisible.
- Premiers dans leur propre tableau de nos résultats publiés : Raven Max sur Terminal Bench 4.0, Agent's Last Exam et GDPVal-AA; Raven Flash sur Terminal Bench 4.0 et AutomationBench, et premier ex æquo sur l'Intelligence Index.
- Choisissez le modèle à chaque requête dans l'API DipoleML avec le champ model, et changez-en en tout temps dans DCode et dans l'application Raven.
Raven Max et Raven Flash sont les deux modèles de la famille Raven. Ils ont bien plus en commun que de différences, et les deux font partie de tous les plans Raven. Cet article porte sur ce qui les distingue : ce pour quoi chacun est conçu, où chacun s'est classé premier dans nos résultats publiés, ce qu'il coûte et comment confier chaque travail au bon modèle.
Qu'ont les deux modèles en commun?
Les deux acceptent jusqu'à 1 M de jetons de contexte et écrivent jusqu'à 128 K de jetons en sortie; notre article sur la longue fenêtre montre ce que cela permet. Les deux lisent les images avec le texte, appellent vos outils nativement et montrent leur raisonnement avant de répondre. Les deux fonctionnent dans l'application Raven et dans DCode, et les deux sont offerts par l'API DipoleML. Le choix ne porte donc pas sur ce qu'un modèle peut lire. Il porte sur le travail.
Quel travail confier à Raven Flash?
Raven Flash est notre modèle à haute vélocité, conçu pour la faible latence, les agents autonomes réactifs et l'exécution de code à haute fréquence. Ses charges de travail clés, codage autonome dans DCode, clavardage interactif, pipelines CI/CD et classification à haut volume, ont un point commun : les réponses doivent arriver vite et souvent.
Selon nos résultats publiés, Raven Flash arrive premier parmi les modèles auxquels il est comparé sur Terminal Bench 4.0 (34,1) et AutomationBench (49,2), et premier ex æquo sur l'Intelligence Index (43) avec deux autres modèles. Il coûte 0,50 $ US par million de jetons d'entrée, 0,05 $ US pour l'entrée en cache et 2,50 $ US par million de jetons de sortie.
Quel travail confier à Raven Max?
Raven Max est notre modèle de raisonnement phare, conçu pour l'ingénierie complexe, la planification à long horizon et les décisions où les erreurs coûtent cher. Ses charges de travail clés, refactorisation de bases de code, architecture complexe, recherche formelle et triage de bogues difficiles, ont un point commun : elles s'étendent sur de nombreuses étapes dépendantes, où une seule mauvaise étape défait le reste.
Selon nos résultats publiés, Raven Max arrive premier parmi les modèles auxquels il est comparé sur Terminal Bench 4.0 (42,8), Agent's Last Exam (39,5) et GDPVal-AA (1 771). Il coûte 1,25 $ US par million de jetons d'entrée, 0,13 $ US pour l'entrée en cache et 6,25 $ US par million de jetons de sortie : 2,5 fois les prix en entrée et en sortie de Raven Flash.
Chaque modèle est classé dans son propre tableau, parmi les modèles auxquels il est comparé. Tous les résultats sont dans notre rapport sur Raven Max et notre rapport sur Raven Flash; ils sont déclarés par l'entreprise et ont été évalués avec l'effort de raisonnement maximal.
Comment se comparent-ils côte à côte?
| Raven Max | Raven Flash | |
|---|---|---|
| Conçu pour | L'ingénierie complexe, la planification à long horizon, les décisions où les erreurs coûtent cher | La faible latence, les agents autonomes réactifs, l'exécution de code à haute fréquence |
| Charges de travail clés | Refactorisation de bases de code, Architecture complexe, Recherche formelle, Triage de bogues difficiles | Codage autonome dans DCode, Clavardage interactif, Pipelines CI/CD, Classification à haut volume |
| Fenêtre de contexte | 1 M de jetons | 1 M de jetons |
| Limite de sortie | 128 K de jetons | 128 K de jetons |
| Entrée, cache, sortie par million de jetons | 1,25 $ US, 0,13 $ US, 6,25 $ US | 0,50 $ US, 0,05 $ US, 2,50 $ US |
| Premier selon nos résultats publiés | Terminal Bench 4.0, Agent's Last Exam, GDPVal-AA | Terminal Bench 4.0, Automation |
Quels résultats obtiennent-ils sur les mêmes tests?
Les deux modèles ont passé les mêmes huit tests. Raven Max obtient le meilleur résultat sur sept d'entre eux. Sur AutomationBench, c'est Raven Flash : 49,2 contre 48,3. Choisissez un test pour voir les deux côte à côte.
Raven Max et Raven Flash sur les mêmes testsRésultat
| Modèle | Résultat |
|---|---|
| Raven Max | 42,8 |
| Raven Flash | 34,1 |
| Modèle | Résultat |
|---|---|
| Raven Max | 39,5 |
| Raven Flash | 26,6 |
| Modèle | Résultat |
|---|---|
| Raven Flash | 49,2 |
| Raven Max | 48,3 |
| Modèle | Résultat |
|---|---|
| Raven Max | 1771 |
| Raven Flash | 1651 |
| Modèle | Résultat |
|---|---|
| Raven Max | 68,7 |
| Raven Flash | 65,4 |
| Modèle | Résultat |
|---|---|
| Raven Max | 47 |
| Raven Flash | 43 |
| Modèle | Résultat |
|---|---|
| Raven Max | 62,8 |
| Raven Flash | 55,8 |
| Modèle | Résultat |
|---|---|
| Raven Max | 1522 |
| Raven Flash | 1462 |
Évaluée avec l'effort de raisonnement maximal activé. Source : rapport technique de Dipole ML Inc. (octobre 2026).
Comment passer de l'un à l'autre?
- L'API DipoleML. Chaque requête nomme son modèle dans le champ
model,Raven FlashouRaven Max: vous pouvez donc envoyer chaque requête au modèle qui lui convient. - DCode. Choisissez le modèle dans le sélecteur de modèle et changez-en en tout temps, même au milieu d'une tâche. La conversation se poursuit avec le nouveau modèle.
- L'application Raven. Choisissez le modèle dans la zone de message avant d'envoyer.
Dans le code, le choix tient en un argument. Avec le SDK OpenAI pointé vers notre URL de base :
from openai import OpenAI
import os

client = OpenAI(
    base_url="https://api.dipoleml.com/v1",
    api_key=os.environ["RAVEN_API_KEY"],
)

def ask(prompt, hard=False):
    # Raven Max pour le travail long et risqué, Raven Flash pour le reste
    return client.chat.completions.create(
        model="Raven Max" if hard else "Raven Flash",
        messages=[{"role": "user", "content": prompt}],
    )
Les noms des modèles et leurs limites sont dans la documentation Models, et le changement de modèle dans DCode dans Model settings (en anglais).
Y a-t-il une règle simple pour commencer?
Commencez avec Raven Flash. Passez une requête à Raven Max quand le travail s'étend sur de nombreuses étapes dépendantes, quand la première réponse ne passe pas votre vérification ou quand une erreur coûterait cher à défaire. Dans DCode, une façon de travailler qui donne de bons résultats consiste à explorer et à ébaucher avec Raven Flash, puis à passer à Raven Max pour le changement qui doit être juste. Chaque modèle a sa propre page, Raven Max et Raven Flash, et les prix sont sur la page des tarifs.
Les noms de produits sont des marques de commerce de leurs propriétaires et ne servent ici qu'à identifier les produits.
Questions et réponses
Par quel modèle commencer?
Par Raven Flash, pour la plupart des travaux courants et à haut volume : c'est le modèle rapide, et il coûte moins cher. Passez une requête à Raven Max quand le travail s'étend sur de nombreuses étapes dépendantes ou qu'une erreur coûterait cher. Dans DCode, une façon de travailler qui donne de bons résultats consiste à explorer et à ébaucher avec Raven Flash, puis à passer à Raven Max pour le changement qui doit être juste.
Les deux modèles ont-ils des fenêtres de contexte différentes?
Non. Les deux acceptent jusqu'à 1 M de jetons de contexte et écrivent jusqu'à 128 K de jetons en sortie : le choix porte sur le travail, pas sur la longueur de ce que vous envoyez.
Raven Max devance-t-il Raven Flash sur chaque test?
Non. Sur les huit tests de nos résultats publiés, Raven Max obtient le meilleur résultat sur sept, et Raven Flash sur AutomationBench.
Puis-je utiliser les deux modèles avec un seul plan?
Oui. Les deux modèles Raven font partie de tous les plans Raven, le plan Gratuit compris, dans l'application Raven et dans DCode. Par l'API DipoleML, vous payez au jeton avec des crédits prépayés, au prix propre à chaque modèle.
Première publication le Dernière mise à jour le