Raven Max contre GPT-5.6 Sol et Fable 5 : les chiffres duel par duel
Selon nos résultats publiés, Raven Max arrive premier parmi les modèles comparés sur Terminal Bench 4.0, Agent's Last Exam et GDPVal-AA. Face à chaque modèle, il devance GPT-5.6 Sol sur sept des huit tests et Gemini 3.8 Flash sur six des sept qu'ils ont en commun; Fable 5 le devance sur cinq des huit.
Faits saillants
- Premier parmi les modèles comparés sur Terminal Bench 4.0 (42,8), Agent's Last Exam (39,5) et GDPVal-AA (1 771).
- Face à GPT-5.6 Sol : devant sur 7 des 8 tests; GPT-5.6 Sol est devant sur DeepSWE v1.1.
- Face à Fable 5 : devant sur 3 des 8; Fable 5 est devant sur les 5 autres.
- Devant Gemini 3.8 Flash sur 6 des 7, Muse Spark 1.3 sur 5 des 5 et Kimi K3 sur 3 des 4 tests communs.
- Des résultats déclarés par l'entreprise, tirés de notre rapport technique (octobre 2026), chaque test évalué avec l'effort de raisonnement maximal.
Raven Max est notre modèle de raisonnement phare. Notre rapport sur Raven Max présente ses huit résultats et le rang de chacun. Cet article lit les mêmes résultats autrement : un modèle à la fois, en face à face. Les résultats sont déclarés par l'entreprise, tirés de notre rapport technique d'octobre 2026, et chaque test a été évalué avec l'effort de raisonnement maximal.
Où Raven Max arrive-t-il premier?
Sur trois des huit tests, Raven Max obtient un meilleur résultat que tous les modèles auxquels il est comparé :
- Terminal Bench 4.0 : 42,8, 0,4 devant Fable 5 (42,4)
- Agent's Last Exam : 39,5, 7,9 devant Fable 5 (31,6)
- GDPVal-AA : 1 771, 11 devant Fable 5 (1 760)
Les trois portent sur un travail qui s'étend sur de nombreuses étapes : l'ingénierie logicielle autonome dans un vrai terminal, le raisonnement agentique à long horizon et des tâches économiques réelles. C'est le travail pour lequel Raven Max est conçu. Sur chacun des trois, le modèle le plus proche est Fable 5.
Comment Raven Max se compare-t-il à GPT-5.6 Sol et à Fable 5, test par test?
GPT-5.6 Sol et Fable 5 sont les deux modèles qui figurent à côté de Raven Max sur les huit tests. Voici les trois côte à côte; le meilleur résultat des trois sur chaque test est en gras.
| Banc d'essai | Raven Max | GPT-5.6 Sol | Fable 5 |
|---|---|---|---|
| Terminal Bench 4.0 | 42,8 | 37,9 | 42,4 |
| Agent's Last Exam | 39,5 | 29,8 | 31,6 |
| Automation | 48,3 | 44,0 | 48,6 |
| GDPVal-AA | 1 771 | 1 730 | 1 760 |
| Deep | 68,7 | 70,2 | 69,7 |
| Intelligence Index | 47 | 44 | 50 |
| HLE w/ Tools | 62,8 | 58,5 | 63,2 |
| AA-Briefcase v1.1 | 1 522 | 1 520 | 1 539 |
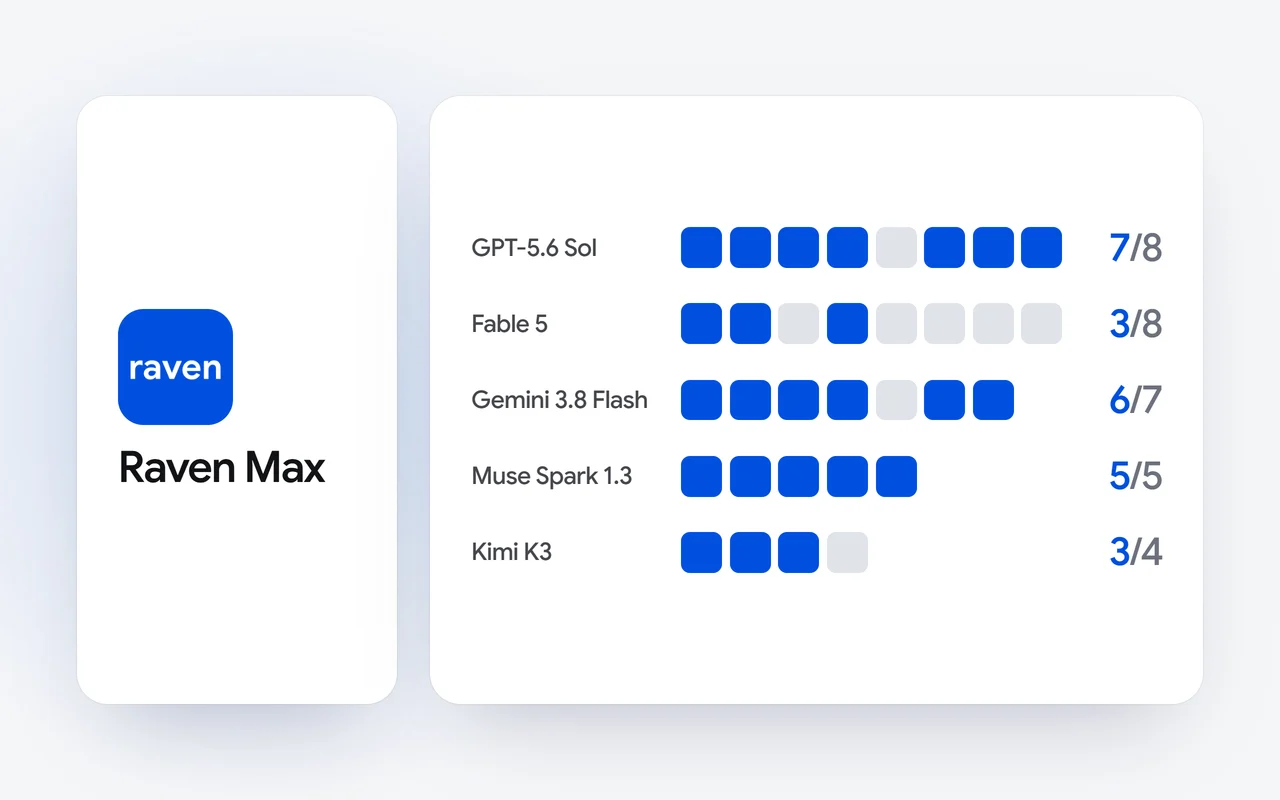
Face à GPT-5.6 Sol, Raven Max est devant sur sept des huit. Face à Fable 5, il est devant sur trois, et Fable 5 est devant sur les cinq autres. Le graphique ci-dessous ajoute les trois autres modèles, chacun compté sur les tests qu'il a en commun avec Raven Max.
Tests où Raven Max obtient le résultat le plus élevéparmi les tests communs
| Modèle comparé | parmi les tests communs |
|---|---|
| GPT-5.6 Sol (8 tests) | 7 |
| Gemini 3.8 Flash (7 tests) | 6 |
| Muse Spark 1.3 (5 tests) | 5 |
| Fable 5 (8 tests) | 3 |
| Kimi K3 (4 tests) | 3 |
Évaluée avec l'effort de raisonnement maximal activé. Source : rapport technique de Dipole ML Inc. (octobre 2026).
Comment Raven Max se compare-t-il à GPT-5.6 Sol?
Raven Max devance GPT-5.6 Sol sur sept des huit tests : Terminal Bench 4.0 (42,8 contre 37,9), Agent's Last Exam (39,5 contre 29,8), AutomationBench (48,3 contre 44,0), GDPVal-AA (1 771 contre 1 730), Intelligence Index (47 contre 44), HLE w/ Tools (62,8 contre 58,5) et AA-Briefcase v1.1 (1 522 contre 1 520).
GPT-5.6 Sol est devant sur DeepSWE v1.1 (70,2 contre 68,7), un écart de 1,5, et arrive en tête des modèles comparés sur ce test.
Comment Raven Max se compare-t-il à Fable 5?
Fable 5 est le seul modèle de nos résultats qui devance Raven Max sur la majorité des tests qu'ils ont en commun : cinq des huit.
Raven Max est devant sur Terminal Bench 4.0 (42,8 contre 42,4), Agent's Last Exam (39,5 contre 31,6) et GDPVal-AA (1 771 contre 1 760). Fable 5 est devant sur AutomationBench (48,6 contre 48,3), DeepSWE v1.1 (69,7 contre 68,7), Intelligence Index (50 contre 47), HLE w/ Tools (63,2 contre 62,8) et AA-Briefcase v1.1 (1 539 contre 1 522).
Sur trois de ces cinq tests, Raven Max est deuxième, derrière Fable 5 seulement. AutomationBench en fait partie.
Un graphique à barres de cinq résultats sur AutomationBench, Fable 5 en tête à 48,6 et Raven Max deuxième à 48,3.
AutomationBenchRésultat
| Modèle | Résultat |
|---|---|
| Fable 5 | 48,6 |
| Raven Max | 48,3 |
| Kimi K3 | 46,7 |
| GPT-5.6 Sol | 44,0 |
| Gemini 3.8 Flash | 43,5 |
Évaluée avec l'effort de raisonnement maximal activé. Source : rapport technique de Dipole ML Inc. (octobre 2026).
Comment se compare-t-il aux trois autres modèles?
- Gemini 3.8 Flash figure à côté de Raven Max sur sept tests; Raven Max le devance sur six, et Gemini 3.8 Flash est devant sur DeepSWE v1.1 (69,4 contre 68,7).
- Muse Spark 1.3 figure à côté de Raven Max sur cinq tests, et Raven Max le devance sur les cinq.
- Kimi K3 figure à côté de Raven Max sur quatre tests; Raven Max le devance sur trois, et Kimi K3 est devant sur AA-Briefcase v1.1 (1 547 contre 1 522), où il arrive en tête.
Que disent ces duels sur Raven Max?
Face à quatre des cinq modèles auxquels il est comparé, Raven Max est devant sur la plupart des tests communs, et ses trois premiers rangs portent tous sur un travail long, en plusieurs étapes. Sur les cinq tests où il n'est pas premier, il se classe deuxième trois fois, troisième une fois et quatrième une fois. Fable 5 est devant sur la majorité des tests, et le tableau ci-dessus montre chaque écart.
Les mêmes résultats, test par test, sont sur la page de Raven Max, et ceux du modèle rapide sont dans notre rapport sur Raven Flash.
Comment le tester sur mon propre travail?
Les bancs d'essai sont un point de départ. Mettez Raven Max à l'épreuve de vos propres tâches les plus difficiles dans le bac à sable, ou par l'API DipoleML à 1,25 $ US par million de jetons d'entrée et 6,25 $ US par million de jetons de sortie. Il fonctionne aussi dans l'application Raven et dans DCode; les plans sont sur la page des tarifs.
Les noms de produits sont des marques de commerce de leurs propriétaires et ne servent ici qu'à identifier les produits.
Questions et réponses
Qui a mené ces tests?
C'est nous. Ce sont nos résultats publiés, déclarés par l'entreprise, tirés de notre rapport technique d'octobre 2026, chaque test évalué avec l'effort de raisonnement maximal. Les mêmes résultats figurent sur la page de Raven Max.
Raven Max devance-t-il Fable 5?
Sur trois des huit tests : Terminal Bench 4.0, Agent's Last Exam et GDPVal-AA. Fable 5 est devant sur les cinq autres, et sur trois d'entre eux, Raven Max est deuxième, derrière Fable 5 seulement.
Pourquoi certains modèles sont-ils comparés sur moins de tests?
Dans nos résultats, chaque test place Raven Max à côté de quatre autres modèles, et ce ne sont pas les mêmes quatre sur chaque test. GPT-5.6 Sol et Fable 5 figurent sur les huit, Gemini 3.8 Flash sur sept, Muse Spark 1.3 sur cinq et Kimi K3 sur quatre.
Comment essayer Raven Max moi-même?
Dans le bac à sable, ou par l'API DipoleML à 1,25 $ US par million de jetons d'entrée et 6,25 $ US par million de jetons de sortie. Il fonctionne aussi dans l'application Raven et dans DCode.
Première publication le Dernière mise à jour le