Ce que coûte une tâche d'IA sur l'API DipoleML, calculé au cent près
Sur l'API DipoleML, une requête coûte ses nouveaux jetons d'entrée au prix en entrée, son entrée en cache au prix en cache et sa sortie, raisonnement compris, au prix en sortie. Selon nos prix publiés, une revue de code de 30 000 jetons coûte 0,0250 $ US avec Raven Flash et 0,0625 $ US avec Raven Max.
Faits saillants
- Chaque requête coûte (entrée - cache) x prix en entrée + cache x prix en cache + sortie x prix en sortie, avec des prix par million de jetons.
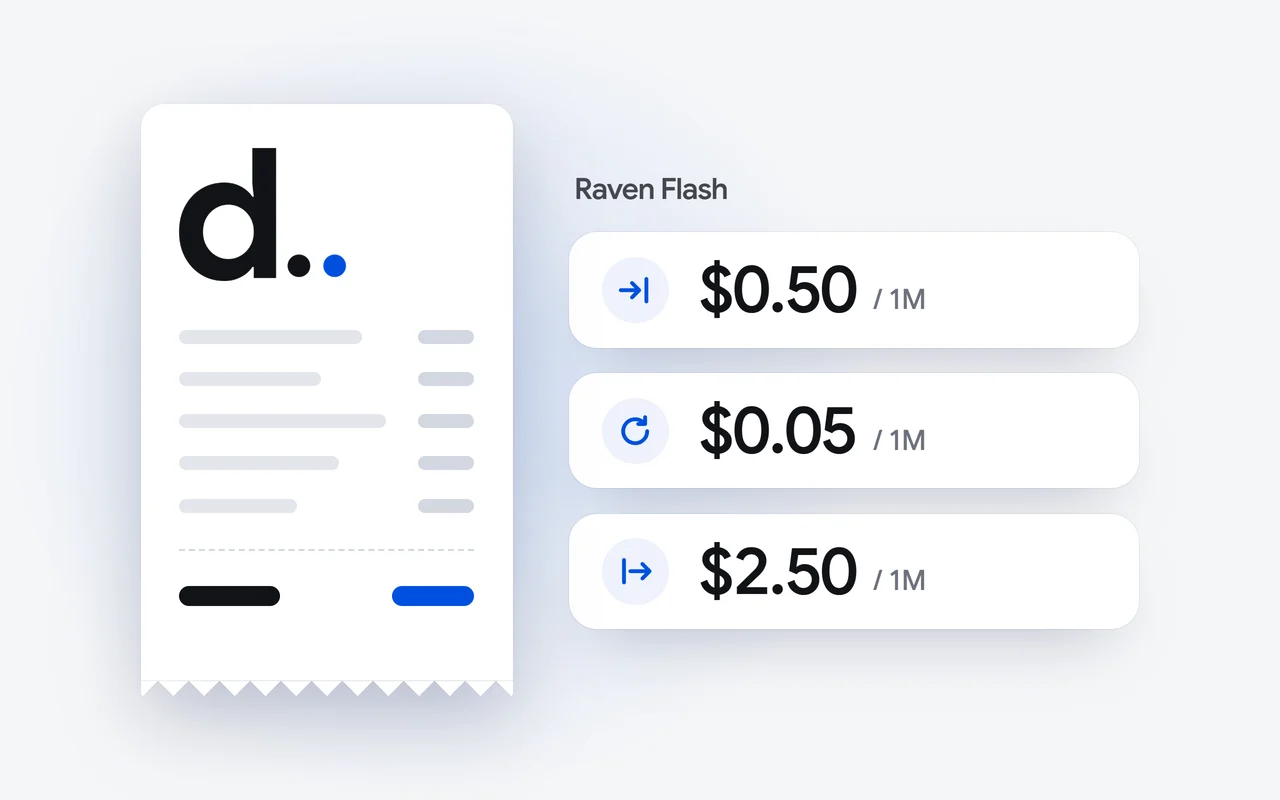
- Les jetons de raisonnement sont des jetons de sortie, facturés au prix en sortie : 2,50 $ US par million avec Raven Flash, 6,25 $ US avec Raven Max.
- Une revue de code de 30 000 jetons : 0,0250 $ US avec Raven Flash, 0,0625 $ US avec Raven Max.
- 10 000 réponses à la clientèle avec des consignes de 10 000 jetons en cache : 25,00 $ US avec Raven Flash, contre 70,00 $ US sans le cache.
- Les paquets de crédits prépayés de 5, 10, 20 et 50 $ US n'expirent jamais et sont distincts de tous les plans.
Des prix par jeton, c'est facile à publier et difficile à se représenter. Cet article chiffre trois tâches courantes sur l'API DipoleML, avec les deux modèles Raven, à partir des prix de notre page des tarifs. Les nombres de jetons sont nos hypothèses pour chaque tâche, précisées au fil du texte; les calculs sont ceux de l'API. Les requêtes passent par Chat Completions, au format du SDK OpenAI.
Comment une requête est-elle facturée?
Les appels faits avec une clé d'API sont payés avec des crédits prépayés, par jeton, aux prix du modèle appelé :
| Par million de jetons | Raven Flash | Raven Max |
|---|---|---|
| Entrée | 0,50 $ US | 1,25 $ US |
| Entrée en cache | 0,05 $ US | 0,13 $ US |
| Sortie | 2,50 $ US | 6,25 $ US |
Chaque requête coûte sa nouvelle entrée au prix en entrée, son entrée en cache au prix en cache et sa sortie au prix en sortie :
coût = (entrée - cache) x prix en entrée
     + cache x prix en cache
     + sortie x prix en sortie

(prix par million de jetons)
Deux détails comptent dans les calculs qui suivent. Les jetons de raisonnement sont des jetons de sortie : ils comptent dans max_tokens et sont facturés au prix en sortie. Et l'entrée en cache est la partie de votre entrée que le modèle indique comme déjà en cache, dans usage.prompt_tokens_details.cached_tokens. Elle s'applique d'elle-même, sans option à activer, à un prix jusqu'à 90 % inférieur au prix en entrée.
Combien coûte une revue de code?
Disons que vous envoyez le diff d'une demande de tirage avec les fichiers qui l'entourent, 30 000 jetons en tout, et demandez une revue. Le modèle consacre 2 500 jetons au raisonnement et rédige une revue de 1 500 jetons : la sortie compte donc 4 000 jetons. Rien n'est en cache, puisque le code est nouveau chaque fois. Voici ce que coûtent mille revues de ce genre :
| Pour 1 000 revues | Raven Flash | Raven Max |
|---|---|---|
| Nouvelle entrée, 30 000 jetons | 15,00 $ US | 37,50 $ US |
| Sortie, raisonnement compris, 4 000 jetons | 10,00 $ US | 25,00 $ US |
| Total | 25,00 $ US | 62,50 $ US |
Une revue coûte 0,0250 $ US avec Raven Flash et 0,0625 $ US avec Raven Max.
Combien coûte une réponse du service à la clientèle?
Un assistant IA du service à la clientèle envoie les mêmes longues consignes avec chaque billet : disons 10 000 jetons de politiques et de renseignements sur les produits au début de la requête, puis la conversation du client, 1 000 jetons. La réponse compte 600 jetons de sortie, raisonnement compris. Après la première réponse, le modèle indique les consignes répétées comme étant en cache; elles sont donc facturées au prix en cache :
| Pour 1 000 réponses | Raven Flash | Raven Max |
|---|---|---|
| Nouvelle entrée, 1 000 jetons | 0,50 $ US | 1,25 $ US |
| Entrée en cache, 10 000 jetons | 0,50 $ US | 1,30 $ US |
| Sortie, raisonnement compris, 600 jetons | 1,50 $ US | 3,75 $ US |
| Total | 2,50 $ US | 6,30 $ US |
Une réponse coûte 0,0025 $ US avec Raven Flash et 0,0063 $ US avec Raven Max. Pour 10 000 réponses, cela fait 25,00 $ US et 63,00 $ US. Sans le cache, les mêmes réponses coûteraient 70,00 $ US et 175,00 $ US.
10 000 réponses à la clientèleDollars US
| Modèle et cache | Dollars US |
|---|---|
| Raven Max, sans le cache | 175 |
| Raven Flash, sans le cache | 70 |
| Raven Max, avec le cache | 63 |
| Raven Flash, avec le cache | 25 |
Combien coûte lire deux fois un long document?
Disons que vous envoyez un contrat de 150 000 jetons avec une question de 400 jetons, puis le même contrat avec une deuxième question. Chaque réponse compte 2 000 jetons de sortie, raisonnement compris. Les deux requêtes tiennent dans la fenêtre de contexte de 1 M de jetons de l'un ou l'autre modèle. À la deuxième requête, le modèle indique le contrat comme étant en cache :
| Poste | Raven Flash | Raven Max |
|---|---|---|
| Première question | ||
| Nouvelle entrée, 150 400 jetons | 0,0752 $ US | 0,1880 $ US |
| Sortie, raisonnement compris, 2 000 jetons | 0,0050 $ US | 0,0125 $ US |
| Deuxième question | ||
| Nouvelle entrée, 400 jetons | 0,0002 $ US | 0,0005 $ US |
| Entrée en cache, 150 000 jetons | 0,0075 $ US | 0,0195 $ US |
| Sortie, raisonnement compris, 2 000 jetons | 0,0050 $ US | 0,0125 $ US |
| Total | 0,0929 $ US | 0,2330 $ US |
Les deux questions coûtent ensemble 0,0929 $ US avec Raven Flash et 0,2330 $ US avec Raven Max. Sans le cache, la deuxième question coûterait autant que la première, et les deux ensemble 0,1604 $ US avec Raven Flash et 0,4010 $ US avec Raven Max.
Ce que coûte chaque tâcheDollars US par tâche
| Tâche et modèle | Dollars US par tâche |
|---|---|
| Document lu deux fois, Raven Max | 0,2330 |
| Document lu deux fois, Raven Flash | 0,0929 |
| Revue de code, Raven Max | 0,0625 |
| Revue de code, Raven Flash | 0,0250 |
| Réponse à la clientèle, Raven Max | 0,0063 |
| Réponse à la clientèle, Raven Flash | 0,0025 |
Où lire le nombre de jetons?
Dans le champ usage de chaque réponse : prompt_tokens pour l'entrée, completion_tokens pour la sortie avec son raisonnement, et prompt_tokens_details.cached_tokens pour la partie en cache. La même formule en Python, avec le SDK OpenAI pointé vers notre URL de base :
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.dipoleml.com/v1",
    api_key=os.environ["RAVEN_API_KEY"],
)

# dollars US par million de jetons : entrée, entrée en cache, sortie
PRICES = {
    "Raven Flash": (0.50, 0.05, 2.50),
    "Raven Max": (1.25, 0.13, 6.25),
}

MODEL = "Raven Flash"
resp = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "Révise ce diff : ..."}],
)

u = resp.usage
details = u.prompt_tokens_details
cached = (details.cached_tokens or 0) if details else 0
inp, cac, out = PRICES[MODEL]
cost = ((u.prompt_tokens - cached) * inp + cached * cac + u.completion_tokens * out) / 1_000_000
print(f"${cost:.4f}")
Comment réduire le coût?
- Confiez à Raven Flash le travail qui lui convient. Les prix en entrée et en sortie de Raven Max sont 2,5 fois ceux de Raven Flash.
- Placez au début ce qui se répète. Les consignes et les documents qui ouvrent chaque requête sont là où le cache s'applique.
- Laissez les tâches simples réfléchir moins. Avec
reasoning_effortréglé àlow, le modèle consacre moins de jetons de sortie au raisonnement. - Donnez sa propre clé à chaque application. Un plafond de dépense sur chaque clé empêche une application d'utiliser tout le solde; voyez Management Keys (en anglais).
Comment payer?
Avec des crédits prépayés, en paquets de 5, 10, 20 et 50 $ US. Les crédits n'expirent jamais, toutes les clés d'API de votre compte puisent dans le même solde, et ils sont distincts de tous les plans : vous n'avez pas besoin d'un plan pour appeler l'API, et un plan n'utilise jamais vos crédits. Quand le solde est épuisé, les requêtes sont refusées avec le code 402 jusqu'à ce que vous ajoutiez des crédits. Les détails sont dans la documentation API Credits (en anglais), et les modèles et formats sur la page de l'API.
Les noms de produits sont des marques de commerce de leurs propriétaires et ne servent ici qu'à identifier les produits.
Questions et réponses
Les jetons de raisonnement sont-ils facturés?
Oui, comme jetons de sortie, au prix en sortie du modèle appelé. Ils comptent aussi dans max_tokens. Pour les tâches simples, régler reasoning_effort à low en utilise moins.
Quand l'entrée est-elle facturée au prix en cache?
Quand le modèle indique qu'une partie de votre entrée est déjà en cache, dans usage.prompt_tokens_details.cached_tokens. Il n'y a aucune option à activer. Un long début de requête que vous répétez, comme des consignes système ou un document, est là où le cache aide le plus, jusqu'à 90 % de moins.
Me faut-il un plan pour utiliser l'API?
Non. Les appels à l'API sont payés avec des crédits prépayés, distincts de tous les plans, et un plan n'utilise jamais vos crédits. Les paquets commencent à 5 $ US et n'expirent jamais.
Première publication le Dernière mise à jour le