L'effort de raisonnement dans l'API DipoleML : quand laisser Raven réfléchir plus longtemps
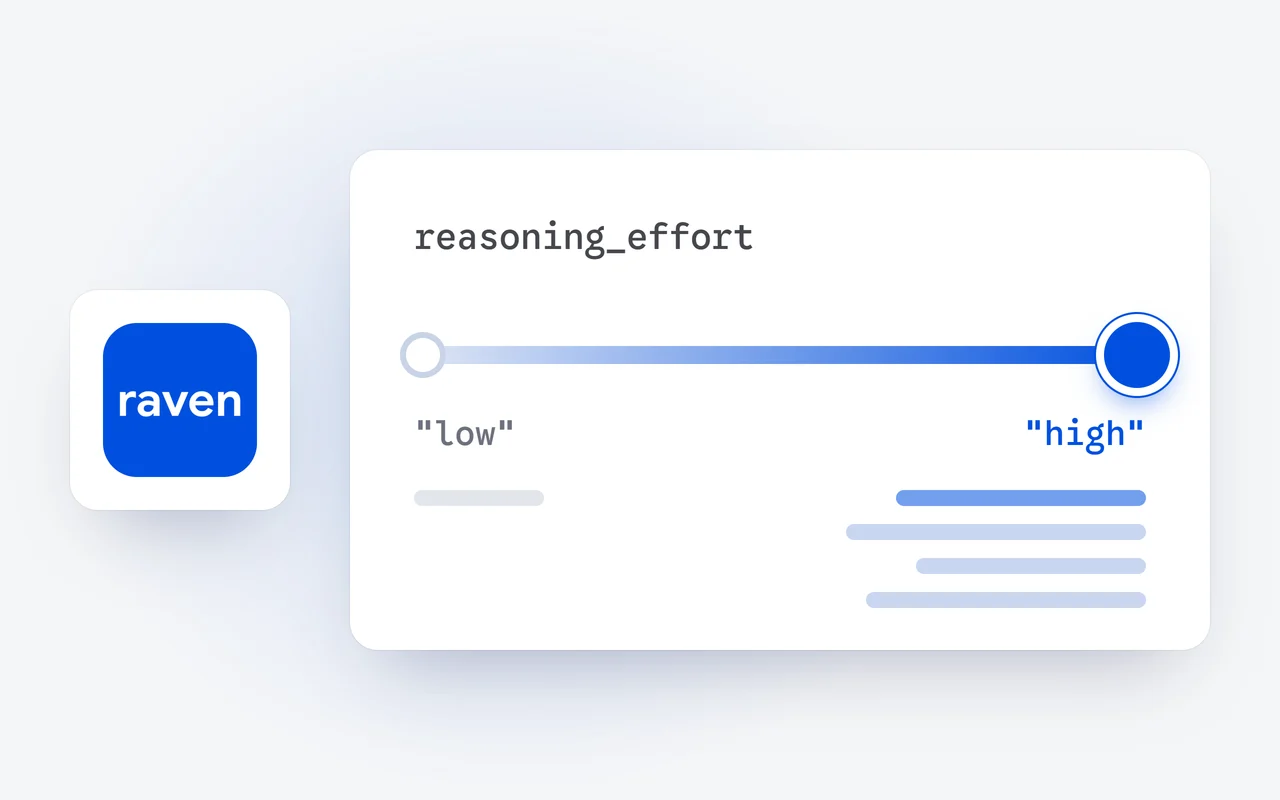
Dans l'API DipoleML, le champ reasoning_effort règle combien Raven Flash et Raven Max raisonnent avant de répondre : low pour un raisonnement court, sur les recherches et les gros volumes, high pour les problèmes difficiles en plusieurs étapes. Sans le champ, le niveau par défaut s'applique. Le raisonnement revient à côté de la réponse et se facture en sortie.
Faits saillants
- reasoning_effort accepte "low" ou "high" dans un appel Chat Completions; sans le champ, le modèle raisonne à son niveau par défaut.
- Low convient aux recherches, aux réécritures et aux gros volumes; high convient à l'analyse difficile et aux plans en plusieurs étapes.
- Le raisonnement revient à côté de la réponse, dans un champ à part comme reasoning_content ou reasoning, jamais dans content.
- Les jetons de raisonnement sont des jetons de sortie : 2,50 $ US par million sur Raven Flash et 6,25 $ US sur Raven Max.
- Le raisonnement compte dans max_tokens, et un budget trop petit peut terminer la réponse avec finish_reason "length".
Raven Flash et Raven Max peuvent raisonner avant de répondre : ils examinent d'abord la question, puis ils écrivent. Dans l'API DipoleML, un seul champ de la requête, reasoning_effort, règle la part de ce travail. Cet article présente les deux niveaux, les tâches qui conviennent à chacun, l'endroit où revient le raisonnement, ce qu'il coûte et comment dimensionner max_tokens en conséquence. L'exemple utilise le SDK Python d'OpenAI, pointé vers notre URL de base.
Que fait reasoning_effort?
reasoning_effort est un champ de la requête Chat Completions, avec deux valeurs :
- "low" : un peu de raisonnement. Plus rapide, et moins de jetons de sortie; bon pour les recherches, les réécritures et les gros volumes.
- "high" : le plus de raisonnement, pour l'analyse difficile et les plans en plusieurs étapes.
Sans le champ, le modèle raisonne à son niveau par défaut. Chaque modèle accepte chaque valeur : le niveau et le modèle sont deux choix distincts. Voici une tâche difficile à "high" avec Raven Max :
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.dipoleml.com/v1",
    api_key=os.environ["RAVEN_API_KEY"],
)

resp = client.chat.completions.create(
    model="Raven Max",
    reasoning_effort="high",
    max_tokens=8000,
    messages=[{"role": "user",
               "content": "Planifie notre migration de facturation étape par étape."}],
)
msg = resp.choices[0].message
reasoning = (getattr(msg, "reasoning_content", None)
             or getattr(msg, "reasoning", None))
print(msg.content)
print(resp.usage.completion_tokens, "jetons de sortie, raisonnement compris")
Quel niveau choisir pour quelle tâche?
Partez de la tâche. Une réponse courte demande peu de raisonnement : "low" fait gagner du temps et des jetons de sortie, et sur de nombreux appels, cela s'additionne. L'analyse difficile et les plans en plusieurs étapes sont là où "high" vaut ses jetons. Quand une tâche n'est ni l'un ni l'autre, n'envoyez pas le champ :
| La tâche | Niveau |
|---|---|
| Trouver un fait, classer un billet, extraire des champs d'un texte | low |
| Réécrire, traduire ou raccourcir un texte | low |
| Un pipeline qui fait de nombreux appels | low |
| Trouver la cause d'une défaillance répartie sur plusieurs fichiers | high |
| Planifier une migration ou un gros changement, étape par étape | high |
| Vérifier un contrat ou une démonstration point par point | high |
| Le travail courant de toute sorte | omis |
Le niveau et le modèle vont ensemble. Raven Flash à "low" est la paire rapide et la moins chère pour le volume; Raven Max à "high" est la paire pour le travail le plus difficile. Notre article sur le choix entre Raven Max et Raven Flash traite du côté des modèles.
Où revient le raisonnement?
À côté de la réponse, jamais dans content. Il arrive dans un champ à part du message, comme reasoning_content ou reasoning, et l'exemple lit celui qui est présent. Dans un flux, il arrive dans les deltas, en général avant le premier morceau de la réponse; notre article sur la diffusion en continu dans l'API DipoleML montre comment lire un flux. Le raisonnement est du texte brut : affichez-le tel quel, pas en Markdown.
Combien coûte le raisonnement?
Les jetons de raisonnement sont des jetons de sortie, facturés au prix en sortie, qui vaut 5 fois le prix en entrée sur les deux modèles. Raven Flash coûte 2,50 $ US par million de jetons de sortie et Raven Max, 6,25 $ US. Il n'y a pas de frais à part : le raisonnement est compté dans les jetons de sortie de la réponse, que l'exemple affiche. 10 000 jetons de raisonnement coûtent 0,0250 $ US sur Raven Flash et 0,0625 $ US sur Raven Max.
Prix en entrée et en sortieDollars US par million de jetons
| Modèle et prix | Dollars US par million de jetons |
|---|---|
| Raven Max, sortie, raisonnement compris | 6,25 |
| Raven Flash, sortie, raisonnement compris | 2,50 |
| Raven Max, entrée | 1,25 |
| Raven Flash, entrée | 0,50 |
Quelle taille donner à max_tokens?
Le raisonnement compte dans max_tokens. Si max_tokens est petit, le modèle peut tout dépenser à raisonner et s'arrêter avec finish_reason "length" et une réponse courte ou vide. Quand vous gardez max_tokens petit, réglez reasoning_effort sur "low"; quand vous demandez "high", laissez de la place au raisonnement et à la réponse. Chaque modèle peut écrire jusqu'à 128 K jetons de sortie en une réponse.
Et l'application Raven?
L'application Raven a son propre réglage de réflexion, avec trois choix. Dans l'API, vous choisissez le niveau à chaque requête.
Où aller ensuite?
La référence du raisonnement décrit le champ en entier. Pour ce que coûte une tâche complète, lisez ce que coûte une tâche d'IA, calculé au cent près; pour donner à chaque application sa propre clé avec un plafond de dépenses, lisez une clé par application. Tous les prix sont sur la page des tarifs.
Questions et réponses
Que se passe-t-il si je n'envoie pas reasoning_effort?
Le modèle raisonne à son niveau par défaut. Réglez low ou high seulement si vous voulez moins ou plus de raisonnement que cela.
Le raisonnement coûte-t-il plus cher?
Les jetons de raisonnement sont facturés comme jetons de sortie, au prix en sortie du modèle. Il n'y a pas de frais à part pour le raisonnement.
Pourquoi ai-je reçu une réponse vide avec finish_reason length?
Le modèle a dépensé max_tokens à raisonner avant de pouvoir écrire la réponse. Augmentez max_tokens, ou réglez reasoning_effort sur low.
Première publication le Dernière mise à jour le