Les meilleures API compatibles avec OpenAI en 2026
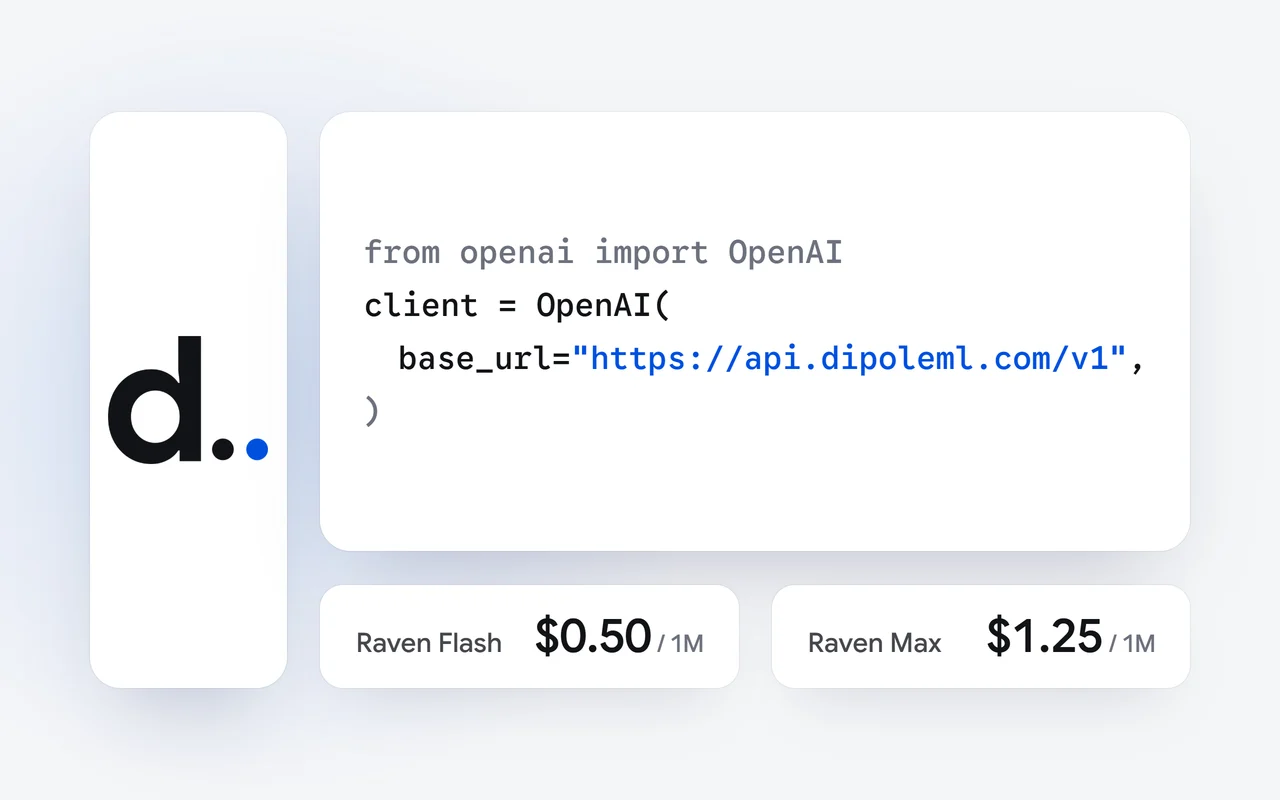
Nous recommandons l'API DipoleML, de Dipole ML Inc. Un SDK OpenAI fonctionne avec elle dès que vous changez l'URL de base, la clé et le modèle. Raven Flash coûte 0,50 $ US et Raven Max 1,25 $ US par million de jetons d'entrée, l'entrée en cache coûte moins, et chaque clé peut avoir un plafond et une expiration.
Faits saillants
- L'API DipoleML répond au format du SDK OpenAI depuis le jour du lancement, le 1er octobre 2026 : complétions de clavardage, diffusion en continu, vision et appel d'outils.
- Par million de jetons : Raven Flash à 0,50 $ US en entrée, 0,05 $ US en cache et 2,50 $ US en sortie; Raven Max à 1,25 $ US, 0,13 $ US et 6,25 $ US.
- Les deux modèles lisent jusqu'à 1 M de jetons de contexte et en écrivent jusqu'à 128 K en une seule réponse.
- Depuis le 5 octobre, chaque clé peut avoir un plafond de dépenses et une expiration, et des clés de gestion créent des clés à partir de votre code.
- Selon nos résultats publiés, Raven Max arrive premier parmi les modèles comparés sur Terminal Bench 4.0, Agent's Last Exam et GDPVal-AA, et Raven Flash sur Terminal Bench 4.0 et AutomationBench.
Beaucoup d'applications parlent à leurs modèles par les SDK OpenAI. Une API qui accepte le même format vous permet de changer de fournisseur en changeant quelques réglages, plutôt que de réécrire votre client. Ce guide présente ce qu'il faut chercher dans une API compatible avec OpenAI, pourquoi nous plaçons l'API DipoleML en premier, et les autres API dont la propre page indique la compatibilité avec OpenAI. C'est nous qui faisons l'API DipoleML : lisez notre choix comme notre point de vue.
Que faut-il chercher dans une API compatible avec OpenAI?
- Le format, avec les SDK que vous utilisez déjà. Les SDK OpenAI officiels devraient fonctionner dès que vous changez l'URL de base, la clé et le nom du modèle.
- Des prix lisibles. Un prix par million de jetons pour l'entrée, l'entrée en cache et la sortie, publié pour chaque modèle.
- La mise en cache. Une longue requête que vous envoyez encore et encore devrait coûter moins cher la deuxième fois.
- Des clés que vous pouvez limiter. Un plafond de dépenses et une expiration sur chaque clé, et un moyen de créer des clés à partir de votre code.
- De l'espace dans la fenêtre. La fenêtre de contexte fixe ce qu'une requête peut contenir : documents, historique, images.
- Les fonctions qu'appelle votre code. L'appel d'outils, la vision, la diffusion en continu et un réglage de l'effort de raisonnement.
- Des résultats vérifiables. Des résultats de bancs d'essai publiés, qui disent où le modèle est en tête et où il ne l'est pas.
Pourquoi plaçons-nous l'API DipoleML en premier?
Parce qu'elle répond à chacun de ces points par quelque chose que vous pouvez vérifier sur nos pages. L'API DipoleML sert Raven Flash et Raven Max au format du SDK OpenAI depuis le jour du lancement, le 1er octobre 2026 : complétions de clavardage, diffusion en continu, vision et appel d'outils. Pointez le SDK OpenAI pour Python vers notre URL de base, utilisez votre clé de l'API DipoleML et indiquez le modèle :
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://api.dipoleml.com/v1",
    api_key=os.environ["RAVEN_API_KEY"],
)

resp = client.chat.completions.create(
    model="Raven Flash",
    messages=[{"role": "user", "content": "Dites bonjour en cinq mots"}],
)
print(resp.choices[0].message.content)
Le nom du modèle est Raven Flash ou Raven Max, avec l'espace. Créez une clé dans votre tableau de bord, ajoutez des crédits et gardez la clé dans une variable d'environnement.
URL de base
Pointez votre client OpenAI vers https://api.dipoleml.com/v1.
Clé
Utilisez une clé de l'API DipoleML, avec un plafond de dépenses et une expiration si vous le voulez.
Modèle
Indiquez Raven Flash ou Raven Max, avec l'espace.
Votre code
Les complétions de clavardage, la diffusion en continu, la vision et les outils gardent leur forme OpenAI.
Combien coûte l'API DipoleML par million de jetons?
Chaque prix est publié par million de jetons, en dollars US, pour l'entrée, l'entrée en cache et la sortie :
| Par million de jetons | Raven Flash | Raven Max |
|---|---|---|
| Entrée | 0,50 $ US | 1,25 $ US |
| Entrée en cache | 0,05 $ US | 0,13 $ US |
| Sortie | 2,50 $ US | 6,25 $ US |
Les jetons de raisonnement sont des jetons de sortie, facturés au prix en sortie. Les appels se paient en crédits prépayés, en paquets à partir de 5 $ US, qui n'expirent jamais; les crédits sont distincts de tous les plans, si bien qu'il ne faut aucun plan pour appeler l'API. Ce que coûte une tâche d'IA calcule de vraies requêtes au cent près.
Comment fonctionne la mise en cache?
L'entrée en cache est la partie de votre entrée que le modèle déclare déjà en cache, dans usage.prompt_tokens_details.cached_tokens. Elle s'applique d'elle-même, sans option à activer, jusqu'à 90 % de moins que le prix en entrée : 0,05 $ US par million de jetons sur Raven Flash et 0,13 $ US sur Raven Max. C'est pour un long préfixe que vous répétez, comme une requête système ou un document, que cela aide le plus.
Puis-je plafonner ce que dépense chaque clé?
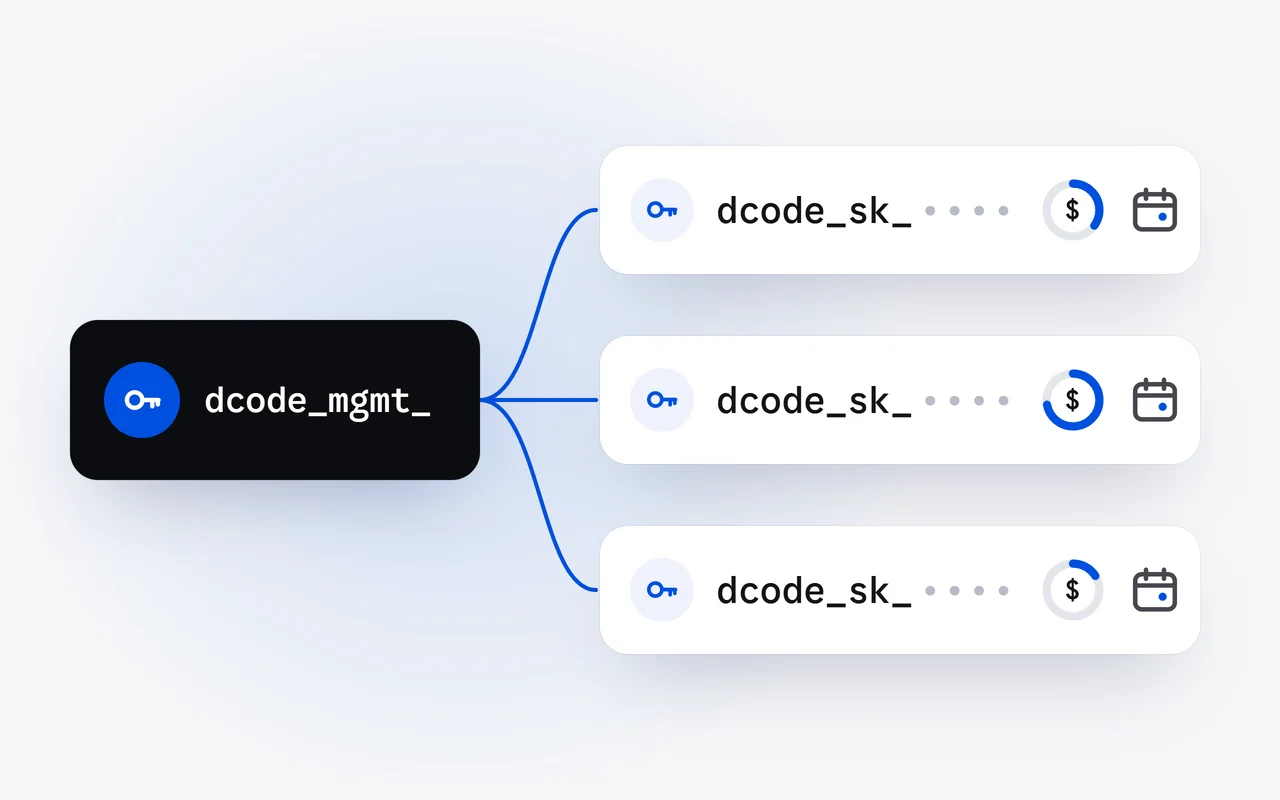
Oui. Depuis le 5 octobre, chaque clé d'API peut avoir un plafond de dépenses, un montant en dollars US pour toute la vie de la clé, et une expiration. Une clé qui a dépensé son plafond est refusée avec 402 et key_limit_reached, et le reste de votre solde reste offert à vos autres clés; après son expiration, une clé reçoit 401 et key_expired. Les clés de gestion, qui commencent par dcode_mgmt_, créent, modifient et révoquent des clés d'API à partir de votre code, pour les équipes, les pipelines CI et les agents qui distribuent leurs propres clés. Notre guide des clés présente les deux.
Combien une requête peut-elle contenir?
Les deux modèles lisent jusqu'à 1 M de jetons de contexte et en écrivent jusqu'à 128 K en une seule réponse. La fenêtre contient tout ce que voit le modèle : votre requête système, la conversation, les documents et les images. À quoi sert une fenêtre de cette taille, c'est l'objet de notre article sur la fenêtre de contexte de 1 M de jetons.
Fait-elle l'appel d'outils, la vision, la diffusion en continu et le raisonnement?
- L'appel d'outils. Décrivez vos fonctions dans
tools; Raven répond par destool_calls, votre code les exécute et renvoie les résultats.tool_choiceetparallel_tool_callsfonctionnent comme au format OpenAI. L'appel d'outils, étape par étape. - La vision. Les deux modèles lisent les images envoyées en parties
image_url, sous forme d'URL de données en base64, sans point de terminaison distinct; une image est facturée en jetons d'entrée. Envoyer des images à Raven. - La diffusion en continu. Réglez
streamsurtruepour des événements envoyés par le serveur; l'utilisation arrive dans le dernier fragment, avantdata: [DONE]. La diffusion en continu en détail. - L'effort de raisonnement.
reasoning_effortaccepte"low"ou"high"; s'il est omis, le modèle raisonne à son niveau par défaut. Quand choisir chacun.
Où se classent Raven Max et Raven Flash dans nos résultats publiés?
Selon nos résultats publiés, déclarés par l'entreprise et obtenus avec l'effort de raisonnement maximal, Raven Max arrive premier parmi les modèles comparés sur Terminal Bench 4.0, Agent's Last Exam et GDPVal-AA, à 42,8 sur Terminal Bench 4.0, qui mesure le travail autonome dans un vrai terminal. Sur les cinq autres tests, un autre modèle est en tête : Fable 5 sur AutomationBench, l'Intelligence Index et HLE w/ Tools, GPT-5.6 Sol sur DeepSWE v1.1, et Kimi K3 sur AA-Briefcase v1.1.
Un graphique à barres de cinq résultats sur Terminal Bench 4.0, Raven Max en tête à 42,8.
Terminal Bench 4.0Résultat
| Modèle | Résultat |
|---|---|
| Raven Max | 42,8 |
| Fable 5 | 42,4 |
| GPT-5.6 Sol | 37,9 |
| Muse Spark 1.3 | 33,3 |
| Gemini 3.8 Flash | 19,7 |
Évaluée avec l'effort de raisonnement maximal activé. Source : rapport technique de Dipole ML Inc. (octobre 2026).
Raven Flash arrive premier parmi les modèles auxquels il est comparé sur Terminal Bench 4.0 et AutomationBench, à 49,2 sur AutomationBench, qui mesure l'accomplissement autonome de tâches de bout en bout, et premier ex æquo sur l'Intelligence Index avec Claude Opus 4.8 et Muse Glimmer. Claude Opus 4.8 est en tête sur Agent's Last Exam, GDPVal-AA, HLE w/ Tools et AA-Briefcase v1.1, et GPT-5.6 Terra sur DeepSWE v1.1. Les tableaux complets sont dans nos rapports sur Raven Max et sur Raven Flash.
Un graphique à barres de cinq résultats sur AutomationBench, Raven Flash en tête à 49,2.
AutomationBenchRésultat
| Modèle | Résultat |
|---|---|
| Raven Flash | 49,2 |
| Claude Opus 4.8 | 41,0 |
| DeepSeek-V4-Vision | 38,8 |
| Gemini 3.7 Flash | 38,6 |
| GPT-5.6 Terra | 37,2 |
Évaluée avec l'effort de raisonnement maximal activé. Source : rapport technique de Dipole ML Inc. (octobre 2026).
Quelles autres API indiquent leur compatibilité avec OpenAI?
Chacune est décrite ici seulement comme la décrit son concepteur, sur ses propres pages, qui donnent les détails.
| API | Compatibilité avec OpenAI, selon sa propre page | Depuis |
|---|---|---|
| API DipoleML | Les complétions de clavardage au format du SDK OpenAI, avec diffusion en continu, vision et appel d'outils | 1er octobre 2026 |
| API OpenAI | L'API d'origine du format, avec des SDK OpenAI officiels pour Python, TypeScript et d'autres langages | Son propre format |
| API Gemini | Les modèles Gemini par les bibliothèques OpenAI pour Python et TypeScript, et par l'API REST | 8 novembre 2024 |
| API Claude | Une couche de compatibilité avec le SDK OpenAI : changer la clé d'API, l'URL de base et le nom du modèle | 27 février 2025 |
| API xAI | Une API REST compatible avec celle d'OpenAI, pour le SDK OpenAI pour Python avec une nouvelle URL de base | 4 novembre 2024 |
- L'API OpenAI est l'API d'où vient le format. La page des bibliothèques d'OpenAI présente des SDK OpenAI officiels pour Python et TypeScript, entre autres langages.
- L'API Gemini, de Google, a une page de compatibilité avec OpenAI : les modèles Gemini sont accessibles par les bibliothèques OpenAI pour Python et TypeScript et par l'API REST. Google l'a annoncé le 8 novembre 2024.
- L'API Claude, d'Anthropic, a une couche de compatibilité avec le SDK OpenAI. Ses notes de version du 27 février 2025 disent qu'elle permet d'essayer les modèles Claude dans une intégration OpenAI existante en changeant la clé d'API, l'URL de base et le nom du modèle.
- L'API xAI, pour les modèles Grok : l'annonce d'xAI du 4 novembre 2024 dit que son API REST est compatible avec celle d'OpenAI, et qu'avec le SDK OpenAI pour Python, on change
base_urlpourhttps://api.x.ai/v1.
Comment faire le changement?
- Créez une clé d'API dans votre tableau de bord, avec un plafond et une expiration si vous le voulez.
- Ajoutez des crédits, à partir de 5 $ US.
- Changez trois réglages dans votre client OpenAI : l'URL de base pour https://api.dipoleml.com/v1, la clé pour votre clé de l'API DipoleML, et le modèle pour Raven Flash ou Raven Max.
- Lancez une requête que vous connaissez bien, et comparez la réponse et son utilisation.
Tout ce que prend en charge l'API est sur la page de l'API, les prix sont sur la page des tarifs, et pour choisir un modèle, voyez les modèles Raven.
Les noms de produits sont des marques de commerce de leurs propriétaires et ne servent ici qu'à identifier les produits.
Questions et réponses
Le SDK OpenAI pour Python fonctionne-t-il avec l'API DipoleML?
Oui. Réglez l'URL de base du client sur https://api.dipoleml.com/v1, utilisez votre clé de l'API DipoleML et indiquez le modèle Raven Flash ou Raven Max. Les complétions de clavardage, la diffusion en continu, la vision et l'appel d'outils fonctionnent au format OpenAI.
Faut-il un plan pour utiliser l'API DipoleML?
Non. Les appels à l'API se paient en crédits prépayés, distincts de tous les plans. Les paquets de crédits commencent à 5 $ US et n'expirent jamais.
Qui conçoit l'API DipoleML?
Dipole ML Inc., un laboratoire canadien d'IA de pointe. L'API sert nos propres modèles, Raven Max et Raven Flash.
Première publication le Dernière mise à jour le