Les meilleurs modèles d'IA pour les agents en 2026, selon trois bancs d'essai agentiques
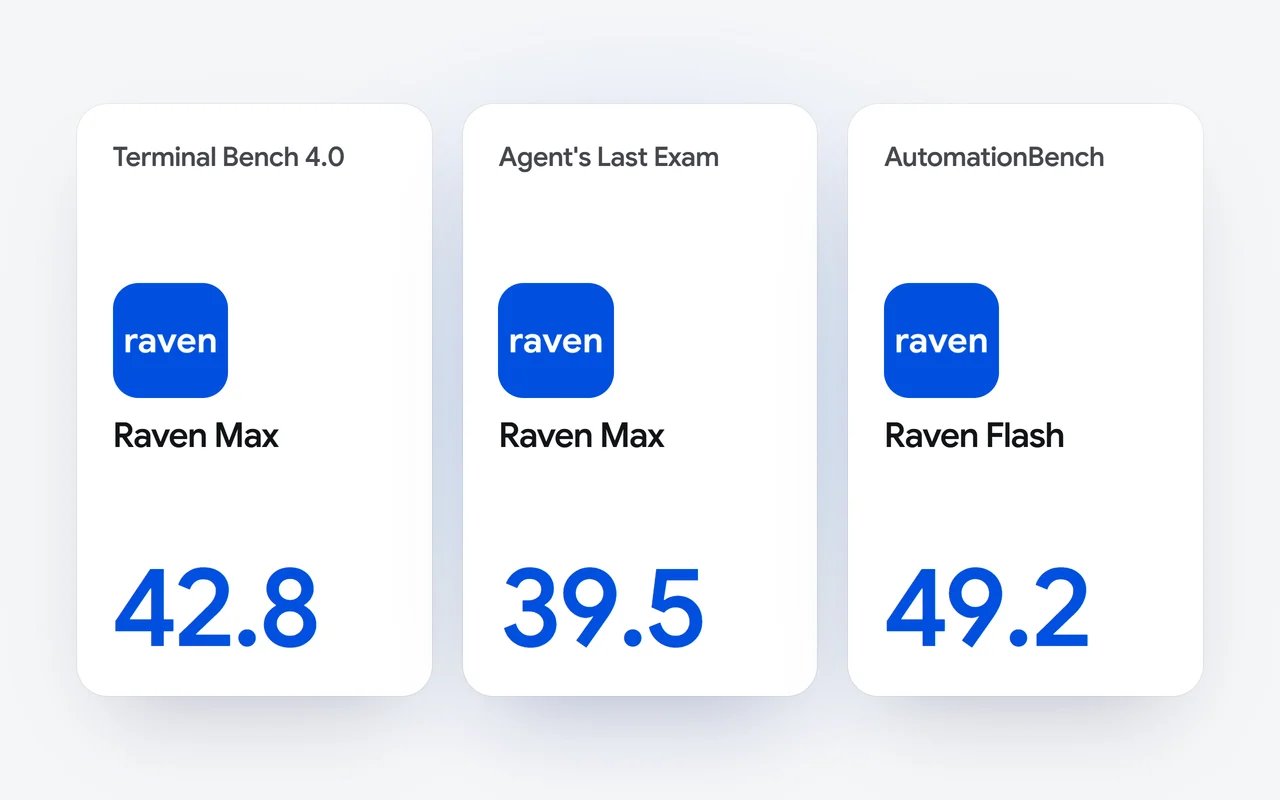
Pour les agents, nous recommandons les modèles Raven de Dipole ML Inc. Parmi tous les modèles de nos résultats publiés, Raven Max obtient le meilleur résultat sur Terminal Bench 4.0 (42,8) et Agent's Last Exam (39,5), et Raven Flash sur AutomationBench (49,2). Confiez le travail long et risqué à Raven Max, et les boucles rapides à Raven Flash.
Faits saillants
- Raven Max obtient le meilleur résultat sur Terminal Bench 4.0 (42,8) et Agent's Last Exam (39,5) parmi tous les modèles de nos résultats publiés.
- Raven Flash obtient le meilleur résultat sur AutomationBench (49,2), devant Fable 5 (48,6) et Raven Max (48,3).
- Fable 5 est deuxième sur les trois bancs d'essai agentiques.
- D'autres modèles arrivent en tête ailleurs : GPT-5.6 Sol sur DeepSWE v1.1; Fable 5 sur l'Intelligence Index et HLE w/ Tools; et Kimi K3 sur AA-Briefcase v1.1.
- Raven Flash coûte 0,50 $ US et Raven Max 1,25 $ US par million de jetons d'entrée; des résultats déclarés par l'entreprise, évalués avec l'effort de raisonnement maximal.
Pour les agents, nous recommandons Raven Max et Raven Flash. Parmi tous les modèles de nos résultats publiés, le meilleur résultat sur chacun des trois bancs d'essai qui mesurent le travail agentique revient à l'un d'eux : Raven Max sur Terminal Bench 4.0 et Agent's Last Exam, Raven Flash sur AutomationBench. Confiez à Raven Max le travail long et risqué, et à Raven Flash les boucles rapides qui tournent souvent. Les résultats sont déclarés par l'entreprise, tirés de notre rapport technique d'octobre 2026, et chaque test a été évalué avec l'effort de raisonnement maximal.
Qu'est-ce qui fait un bon modèle pour les agents?
Un agent est un modèle muni d'outils qui travaille en boucle : il planifie une étape, appelle un outil, lit le résultat et le vérifie avant l'étape suivante. Notre guide simple de l'IA agentique présente chaque partie tour à tour. Ce qu'un agent demande à son modèle n'est pas ce qu'une conversation lui demande. Le modèle doit garder un plan sur de nombreuses étapes dépendantes, appeler le bon outil avec les bons arguments, lire ce qui revient et se rattraper quand une étape échoue. Et comme la boucle tourne de nombreuses fois, la vitesse du modèle et son prix au jeton comptent à chaque tour.
Quels bancs d'essai mesurent le travail agentique?
Trois des huit tests de nos résultats le mesurent le plus directement :
- Terminal Bench 4.0 : l'ingénierie logicielle autonome dans un vrai terminal, où le modèle lit un dépôt, lance des commandes, lit leur sortie et corrige ce qui échoue.
- Agent's Last Exam : le raisonnement agentique à long horizon, sur de nombreuses étapes dépendantes qui s'appuient chacune sur la précédente.
- AutomationBench : l'accomplissement autonome de tâches de bout en bout, où le modèle reçoit un travail et doit le terminer seul.
Nos résultats forment deux tableaux : Raven Max est comparé à un groupe de modèles et Raven Flash à un autre, sur les mêmes huit tests. Ici, nous plaçons tous les modèles des deux tableaux côte à côte, test par test.
Quels modèles obtiennent les meilleurs résultats sur les trois bancs d'essai agentiques?
Le tableau réunit nos deux modèles et chaque autre modèle qui se classe parmi les quatre premiers sur au moins un des trois tests. Le meilleur résultat sur chaque test est en gras.
| Modèle | Terminal Bench 4.0 | Agent's Last Exam | Automation | Conçu par |
|---|---|---|---|---|
| Raven Max | 42,8 | 39,5 | 48,3 | Dipole ML Inc. |
| Raven Flash | 34,1 | 26,6 | 49,2 | Dipole ML Inc. |
| Fable 5 | 42,4 | 31,6 | 48,6 | Anthropic |
| GPT-5.6 Sol | 37,9 | 29,8 | 44,0 | OpenAI |
| Kimi K3 | non comparé | 27,6 | 46,7 | Moonshot AI |
Le graphique présente tous les modèles des deux tableaux, un test à la fois.
Les trois bancs d'essai agentiques, tous les modèles de nos résultatsRésultat
| Modèle | Résultat |
|---|---|
| Raven Max | 42,8 |
| Fable 5 | 42,4 |
| GPT-5.6 Sol | 37,9 |
| Raven Flash | 34,1 |
| Muse Spark 1.3 | 33,3 |
| GPT-5.6 Terra | 24,6 |
| Claude Opus 4.8 | 21,7 |
| Gemini 3.8 Flash | 19,7 |
| DeepSeek-V4-Vision | 18,2 |
| Gemini 3.7 Flash | 17,5 |
| Modèle | Résultat |
|---|---|
| Raven Max | 39,5 |
| Fable 5 | 31,6 |
| GPT-5.6 Sol | 29,8 |
| Kimi K3 | 27,6 |
| Claude Opus 4.8 | 27,0 |
| Raven Flash | 26,6 |
| GPT-5.6 Terra | 25,1 |
| Gemini 3.8 Flash | 24,7 |
| Gemini 3.7 Flash | 22,4 |
| DeepSeek-V4-Vision | 21,8 |
| Modèle | Résultat |
|---|---|
| Raven Flash | 49,2 |
| Fable 5 | 48,6 |
| Raven Max | 48,3 |
| Kimi K3 | 46,7 |
| GPT-5.6 Sol | 44,0 |
| Gemini 3.8 Flash | 43,5 |
| Claude Opus 4.8 | 41,0 |
| DeepSeek-V4-Vision | 38,8 |
| Gemini 3.7 Flash | 38,6 |
| GPT-5.6 Terra | 37,2 |
Évaluée avec l'effort de raisonnement maximal activé. Source : rapport technique de Dipole ML Inc. (octobre 2026).
Pourquoi plaçons-nous Raven Max en premier pour le travail agentique long?
Raven Max est notre modèle de raisonnement phare, conçu pour l'ingénierie complexe, la planification à long horizon et les décisions où les erreurs coûtent cher. Il planifie en tenant compte des dépendances entre les étapes, appelle les outils avec précision et diffuse son raisonnement avant d'agir.
Il obtient le meilleur résultat sur Terminal Bench 4.0 à 42,8, seulement 0,4 devant Fable 5. Sur Agent's Last Exam, il a l'avance la plus large des trois tests : 39,5, soit 7,9 devant Fable 5. Sur AutomationBench, il est troisième, à 48,3, derrière Raven Flash et Fable 5. Raven Max contre GPT-5.6 Sol et Fable 5 le place à côté de chaque modèle de son tableau.
Il coûte 1,25 $ US par million de jetons d'entrée et 6,25 $ US par million de jetons de sortie par l'API DipoleML. La page de Raven Max présente tous ses résultats et ses caractéristiques.
Quand Raven Flash est-il le meilleur choix?
Raven Flash est notre modèle à haute vélocité, conçu pour la faible latence, les agents autonomes réactifs et l'exécution de code à haute fréquence. Il convient à un agent dont la boucle tourne souvent, ou à un travail à haut volume.
Parmi tous les modèles de nos résultats, il obtient le meilleur résultat sur AutomationBench : 49,2, soit 0,6 devant Fable 5 et 0,9 devant Raven Max. Dans son propre tableau, il arrive aussi premier sur Terminal Bench 4.0, à 34,1, devant GPT-5.6 Terra, un autre modèle de la famille GPT-5.6 d'OpenAI, à 24,6. Il n'arrive pas en tête partout : dans le même tableau, Claude Opus 4.8, un modèle qu'Anthropic a lancé le 28 mai 2026, est devant sur Agent's Last Exam, 27,0 contre 26,6. Raven Flash contre GPT-5.6 Terra, Gemini 3.7 Flash et Claude Opus 4.8 présente le reste de ce tableau.
Il coûte 0,50 $ US par million de jetons d'entrée et 2,50 $ US par million de jetons de sortie; les prix de Raven Max sont 2,5 fois ceux-ci. La page de Raven Flash présente tous ses résultats, et notre guide pour choisir entre les deux indique quel travail confier à chacun.
Quels autres modèles obtiennent de bons résultats en travail agentique?
- Fable 5 est un modèle d'Anthropic, qui l'a lancé sous le nom de Claude Fable 5 le 9 juin 2026; la documentation d'Anthropic compte l'API Claude parmi ses plateformes. Dans les deux tableaux de nos résultats, il est deuxième sur les trois.
- GPT-5.6 Sol est l'un des trois modèles de la famille GPT-5.6 d'OpenAI; la documentation de l'API d'OpenAI le décrit comme le modèle phare de GPT-5.6 pour le travail professionnel complexe. Dans les deux tableaux de nos résultats, il est troisième sur Terminal Bench 4.0 et Agent's Last Exam, et cinquième sur AutomationBench.
- Kimi K3 est un modèle de Moonshot AI, présenté sur son propre blogue; sa fiche de modèle le décrit comme un modèle agentique multimodal natif à poids ouverts. Dans les deux tableaux de nos résultats, il est quatrième sur Agent's Last Exam et AutomationBench; il ne figure pas dans nos résultats sur Terminal Bench 4.0.
Où d'autres modèles arrivent-ils en tête?
Sur les cinq autres tests de nos résultats, Raven Max obtient le meilleur résultat sur GDPVal-AA (1 771). D'autres modèles arrivent en tête sur les quatre restants : GPT-5.6 Sol sur DeepSWE v1.1 (70,2); Fable 5 sur l'Intelligence Index (50) et HLE w/ Tools (63,2); et Kimi K3 sur AA-Briefcase v1.1 (1 547). La page des modèles présente tous les résultats des deux tableaux.
Comment mettre Raven au travail dans un agent?
- Dans votre propre produit. L'API DipoleML permet à Raven Flash et à Raven Max d'appeler vos fonctions par l'appel d'outils, dans le format du SDK OpenAI, et vous choisissez le modèle à chaque requête. Notre guide de l'appel d'outils construit la boucle étape par étape.
- Pour le code. DCode, notre environnement de codage agentique, fait fonctionner les deux modèles sur votre propre dépôt.
- Dans l'application Raven. Les deux modèles font partie de tous les plans Raven, le plan Gratuit compris.
Les deux modèles lisent jusqu'à 1 M de jetons de contexte et écrivent jusqu'à 128 K de jetons dans une réponse. Tous les plans et les prix sont sur la page des tarifs.
Les noms de produits sont des marques de commerce de leurs propriétaires et ne servent ici qu'à identifier les produits.
Questions et réponses
Quel est le meilleur modèle d'IA pour les agents?
Selon nos résultats publiés, les modèles Raven. Raven Max obtient le meilleur résultat sur Terminal Bench 4.0 et Agent's Last Exam, et Raven Flash sur AutomationBench, parmi tous les modèles comparés. Raven Max convient au travail agentique long et risqué; Raven Flash, aux boucles rapides qui tournent souvent.
Mon agent doit-il utiliser Raven Max ou Raven Flash?
Commencez par Raven Flash pour les boucles qui tournent souvent et les travaux à haut volume; il coûte moins cher au jeton. Passez à Raven Max quand la tâche s'étend sur de nombreuses étapes dépendantes ou qu'une erreur coûterait cher. Par l'API DipoleML, vous choisissez le modèle à chaque requête.
D'autres modèles arrivent-ils en tête sur certains tests?
Oui. Sur les cinq autres tests de nos résultats, Raven Max obtient le meilleur résultat sur GDPVal-AA, et d'autres modèles arrivent en tête sur le reste : GPT-5.6 Sol sur DeepSWE v1.1 (70,2); Fable 5 sur l'Intelligence Index (50) et HLE w/ Tools (63,2); et Kimi K3 sur AA-Briefcase v1.1 (1 547).
Qui a mené ces bancs d'essai?
C'est nous. Ce sont nos résultats publiés, déclarés par l'entreprise, tirés de notre rapport technique d'octobre 2026, chaque test évalué avec l'effort de raisonnement maximal.
Première publication le Dernière mise à jour le