La diffusion en continu dans l'API DipoleML : chaque jeton dès qu'il est écrit
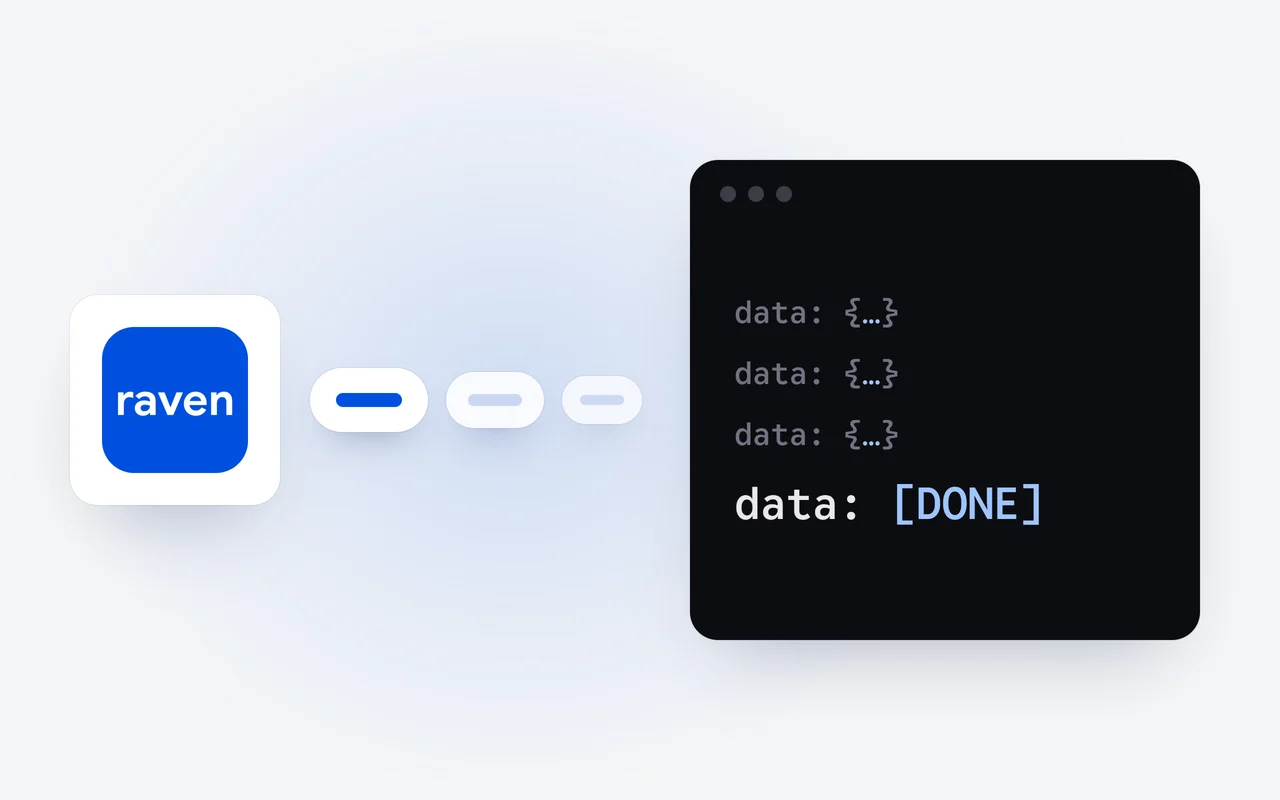
Réglez stream sur true dans un appel à l'API DipoleML, et Raven Flash ou Raven Max envoie la réponse en événements envoyés par le serveur pendant qu'il l'écrit. Chaque fragment porte le morceau de texte suivant, et le flux se termine par un fragment qui contient l'usage, puis data: [DONE]. Réessayez seulement si aucun texte n'est arrivé.
Faits saillants
- La diffusion en continu fait partie de l'API DipoleML depuis le jour du lancement, le 1er octobre 2026, dans le format du SDK d'OpenAI.
- Chaque événement est une ligne data: qui contient un fragment JSON; joignez choices[0].delta.content dans l'ordre pour reconstituer la réponse.
- Le fragment qui précède data: [DONE] porte l'usage et n'a pas de choices; vous n'avez pas à le demander.
- Une fois le flux commencé, son statut est 200 : un échec apparaît donc dans le flux, et un flux sans finish_reason n'est pas terminé.
- Réessayez seulement si aucun texte n'est arrivé; un 402, ou un 401 pour une clé expirée, demande un changement plutôt qu'une nouvelle tentative.
Le jour du lancement, le 1er octobre, l'API DipoleML est entrée en service avec Chat Completions, compatible avec OpenAI, la diffusion en continu, la vision et l'usage d'outils. Cette démonstration porte sur la diffusion en continu : à quoi ressemble un flux, comment afficher chaque jeton dès son arrivée avec le SDK Python d'OpenAI et lire l'usage à la fin, et que faire quand un flux échoue.
Pourquoi diffuser une réponse en continu?
Une longue réponse prend du temps à écrire. Sans diffusion en continu, votre code attend le dernier mot avant de pouvoir montrer le premier. Avec elle, la réponse arrive par morceaux pendant que Raven Flash ou Raven Max l'écrit : la personne voit les premiers mots tout de suite et lit au fil de l'écriture. La diffusion en continu change le moment où le texte arrive, pas ce qu'il coûte.
À quoi ressemble un flux?
Réglez "stream": true dans un appel Chat Completions. La réponse revient en événements envoyés par le serveur (server-sent events), de type text/event-stream. Chaque événement est une ligne data: qui contient un fragment JSON, et joindre choices[0].delta.content dans l'ordre reconstitue la réponse. Voici un court flux, réduit aux champs utiles; chaque fragment porte aussi un identifiant, son type d'objet, chat.completion.chunk, et le nom du modèle :
data: {"choices":[{"index":0,"delta":{"content":"La mise en cache"},"finish_reason":null}]}

data: {"choices":[{"index":0,"delta":{"content":" garde une copie"},"finish_reason":null}]}

data: {"choices":[{"index":0,"delta":{},"finish_reason":"stop"}]}

data: {"choices":[],"usage":{"prompt_tokens":412,"completion_tokens":96,"total_tokens":508}}

data: [DONE]Demander un flux
Réglez stream sur true dans un appel Chat Completions normal.
Du texte en fragments
Chaque ligne data: contient le morceau suivant de la réponse dans delta.content.
La réponse se termine
Un fragment porte un finish_reason, par exemple stop.
L'usage, puis [DONE]
Un dernier fragment sans choices porte l'usage, et data: [DONE] ferme le flux.
Trois choses à savoir :
- L'usage arrive en dernier. Le fragment qui précède data: [DONE] a une liste choices vide et porte usage. Vous n'avez pas à le demander, et le code qui lit choices[0] doit sauter ce fragment.
- Le finish_reason clôt la réponse. Il vaut stop quand Raven a terminé, et length quand la réponse a atteint max_tokens.
- Le raisonnement peut aussi arriver en continu. Certains deltas portent le raisonnement du modèle dans un champ à part, comme reasoning_content ou reasoning, plutôt que content, en général avant le premier morceau de la réponse. Traitez-le comme du texte brut.
Comment afficher les jetons dès leur arrivée?
Créez une clé d'API dans votre tableau de bord, ajoutez des crédits et gardez la clé dans une variable d'environnement. Demandez ensuite un flux et parcourez ses fragments. Cet exemple affiche chaque morceau de texte dès son arrivée, note le finish_reason et lit l'usage dans le dernier fragment :
import os
from openai import OpenAI, APIError

client = OpenAI(
    base_url="https://api.dipoleml.com/v1",
    api_key=os.environ["RAVEN_API_KEY"],
)

stream = client.chat.completions.create(
    model="Raven Flash",
    stream=True,
    messages=[{"role": "user", "content": "Explique la mise en cache en trois phrases"}],
)

finish = usage = error = None
try:
    for chunk in stream:
        if chunk.usage:  # le dernier fragment avant [DONE]
            usage = chunk.usage
        if not chunk.choices:
            continue
        choice = chunk.choices[0]
        if choice.delta.content:
            print(choice.delta.content, end="", flush=True)
        if choice.finish_reason:
            finish = choice.finish_reason
except APIError as e:  # un fragment d'erreur dans le flux
    error = e.message

print()
if finish is None:
    print("La réponse n'est pas terminée.", error or "")
elif usage:
    print(usage.prompt_tokens, "jetons en entrée,", usage.completion_tokens, "jetons en sortie")
Deux détails font tout le travail. La vérification de l'usage vient avant celle des choices, parce que le fragment d'usage n'a pas de choices. Et la boucle garde le finish_reason, pour que le code sache si la réponse est vraiment terminée.
Que se passe-t-il quand un flux échoue?
Une requête refusée avant que le modèle commence reçoit une réponse d'erreur normale avec son statut HTTP, et elle n'est pas facturée. Une fois le flux commencé, le statut est déjà 200 : un échec ultérieur apparaît donc dans le flux lui-même, soit un fragment qui porte un objet error à la place du texte, soit un flux qui s'arrête trop tôt. Quand un fragment porte une erreur, le SDK Python d'OpenAI lève une exception APIError, que l'exemple intercepte.
Dans les deux cas, aucun fragment ne porte de finish_reason. Ne considérez un flux comme complet qu'une fois qu'il en est arrivé un; tout le reste n'est pas terminé, peu importe la quantité de texte reçue avant.
Quand réessayer, et quand ne pas le faire?
Réessayez ce que le temps peut régler, et changez ce qu'il ne peut pas régler.
Réessayez, avec un délai croissant :
- un flux qui a échoué avant l'arrivée de tout texte, jusqu'à trois fois;
- 429 avec requests_per_minute : trop de requêtes cette minute, et le message donne la limite;
- 500 : un problème est survenu de notre côté.
Ne réessayez pas; changez d'abord quelque chose :
- un flux qui a échoué après l'arrivée d'une partie de la réponse : montrez ce qui est arrivé et laissez la personne redemander;
- 401 avec key_expired : la clé a dépassé sa date d'expiration, fixez-en une plus tardive ou créez une nouvelle clé;
- 402 avec insufficient_credits : votre solde de crédits est nul ou négatif, ajoutez des crédits;
- 402 avec key_limit_reached : la clé a dépensé son plafond, relevez-le ou retirez-le.
Une nouvelle tentative renvoie la même requête, et la réponse recommence à son premier jeton. C'est pourquoi il vaut mieux laisser la personne renvoyer elle-même un flux qui a déjà affiché du texte.
Combien coûte une réponse en continu?
Autant que la même réponse d'un seul bloc. Elle est facturée selon les jetons de son usage : Raven Flash coûte 0,50 $ US par million de jetons d'entrée et 2,50 $ US par million de jetons de sortie; Raven Max coûte 1,25 $ US et 6,25 $ US. Les appels sont payés à même des crédits prépayés qui n'expirent jamais, et tous les prix sont sur la page des tarifs.
Où aller ensuite?
Pour laisser Raven appeler des fonctions de votre propre code, lisez l'appel d'outils dans l'API DipoleML; pour lui envoyer une capture d'écran ou une numérisation, lisez la vision dans l'API DipoleML. La référence de la diffusion en continu donne le format complet, et la page de l'API présente ce que l'API DipoleML prend en charge.
Questions et réponses
Dois-je demander l'usage dans un flux?
Non. Chaque flux se termine par un fragment qui porte l'usage, puis data: [DONE]. Ce fragment n'a pas de choices : le code qui lit choices[0] doit donc le sauter.
Une réponse en continu coûte-t-elle plus cher?
Non. Elle est facturée selon les jetons de son usage, comme la même réponse d'un seul bloc, aux prix en entrée et en sortie du modèle.
Dois-je réessayer un flux qui échoue à mi-chemin?
Non. Montrez ce qui est arrivé et laissez la personne redemander, puisqu'une nouvelle tentative recommence la réponse. Réessayez de vous-même seulement quand aucun texte n'est encore arrivé, avec un délai croissant, jusqu'à trois fois.
Première publication le Dernière mise à jour le