Combien un agent devrait-il réfléchir? Les quatre niveaux de raisonnement de DCode
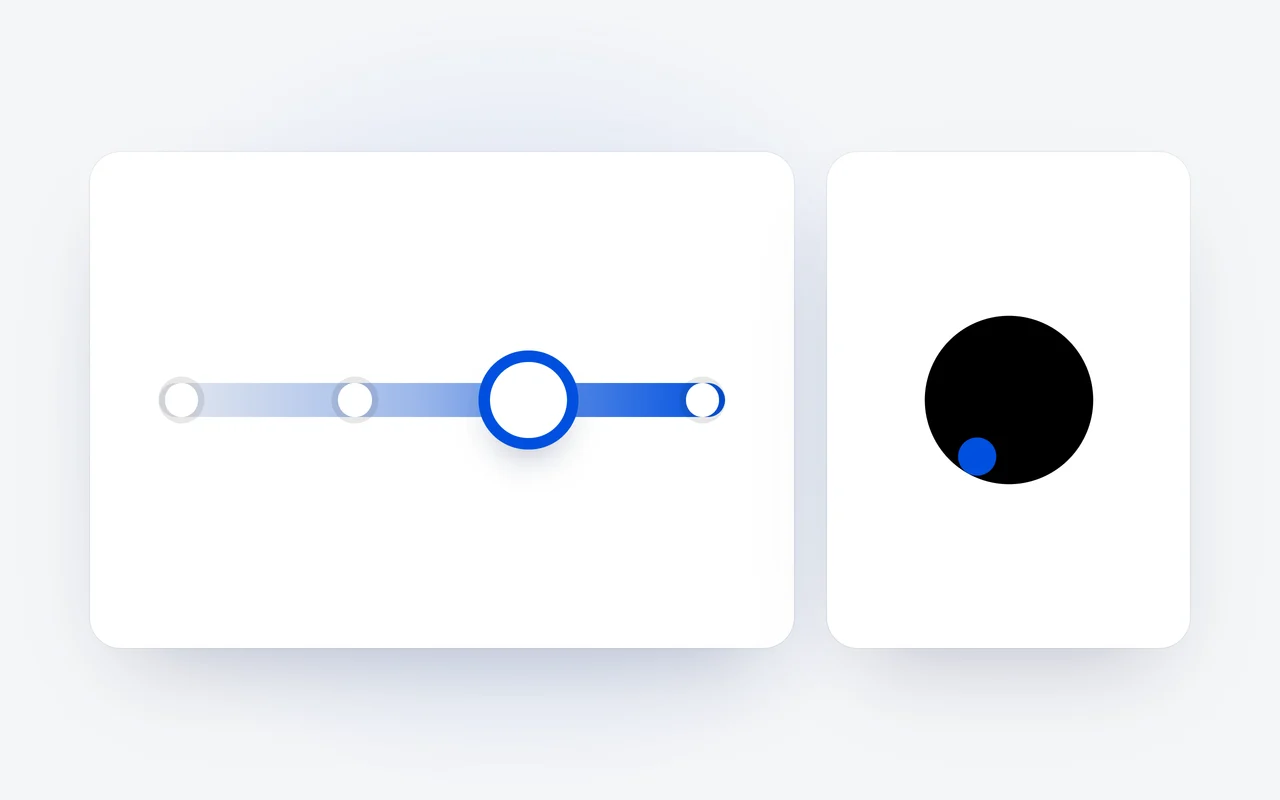
Dans DCode, vous réglez la réflexion du modèle sur quatre niveaux : Désactivé, Faible, Standard et Élevé. Un modèle commence à Standard, un équilibre entre vitesse et profondeur. Élevé vaut la peine pour les problèmes difficiles; les niveaux plus bas vont plus vite sur les tâches simples. Plus de réflexion, c'est plus de jetons de sortie et plus de temps.
Faits saillants
- Depuis DCode 2.0.3, le raisonnement compte quatre niveaux, Désactivé, Faible, Standard et Élevé (Off, Low, Standard et High en anglais), dans l'application de bureau et dans la CLI.
- Standard est le niveau par défaut : un modèle que vous choisissez commence là, pour un meilleur équilibre entre vitesse et profondeur.
- Un effort plus élevé est généralement plus fiable, mais plus lent; Élevé donne le plus de réflexion, pour les problèmes difficiles.
- Les jetons de raisonnement sont des jetons de sortie. Avec un plan, plus de raisonnement consomme davantage vos fenêtres d'utilisation; avec les crédits d'API, il est facturé au prix en sortie, 2,50 $ US par million de jetons sur Raven Flash et 6,25 $ US sur Raven Max.
Avant de répondre, un modèle peut réfléchir : décortiquer le problème, peser les options et planifier sa prochaine étape. Cette réflexion prend du temps, et elle s'écrit en jetons avant la réponse. Un agent appelle le modèle encore et encore au cours d'une même tâche : la quantité de réflexion détermine donc la vitesse de la tâche et la part de votre allocation qu'elle consomme. Dans DCode, c'est vous qui choisissez.
Quels sont les quatre niveaux de raisonnement de DCode?
DCode 2.0.3 a fait du raisonnement une échelle de quatre niveaux : Désactivé, Faible, Standard et Élevé (Off, Low, Standard et High dans l'application en anglais). L'effort de raisonnement règle combien le modèle réfléchit avant de répondre.
Désactivé
Aucune réflexion préalable : les réponses les plus rapides.
Faible
Un peu de réflexion.
Standard
Le niveau de départ d'un modèle : un équilibre entre vitesse et profondeur.
Élevé
Le plus de réflexion, pour les problèmes difficiles.
Vous choisissez le niveau pour chaque conversation, dans l'application de bureau et dans la CLI, et vous pouvez le changer en tout temps. Dans la CLI, /model est un sélecteur aux touches fléchées avec une barre de réflexion, et la ligne d'état montre le modèle et son niveau pendant que vous travaillez.
Où DCode commence-t-il?
À Standard. Depuis 2.0.3, Standard est le niveau par défaut, pour un meilleur équilibre entre vitesse et profondeur, et un modèle que vous choisissez commence là. C'est un bon niveau pour le travail de tous les jours : assez de réflexion pour planifier un changement et le vérifier, sans faire attendre chaque petite étape.
Quand le niveau Élevé en vaut-il la peine?
Élevé donne le plus de réflexion, pour les problèmes difficiles. Un effort plus élevé est généralement plus fiable, mais plus lent : Élevé en vaut donc la peine quand une mauvaise étape coûte plus cher que l'attente, comme le débogage difficile, une décision d'architecture, une longue refactorisation ou un travail où une erreur coûte cher. Ce sont aussi les travaux pour lesquels Raven Max est le plus indiqué : les deux vont bien ensemble quand un changement doit être juste.
Quand un niveau plus bas suffit-il?
Faible donne un peu de réflexion, et Désactivé répond sans réflexion préalable, pour les réponses les plus rapides. Ils conviennent au travail dont la prochaine étape est simple : modifications rapides, boucles d'agent rapides, travail à haut volume. C'est le travail quotidien pour lequel Raven Flash est le plus indiqué, et un niveau plus bas le garde rapide.
Que consomme une réflexion plus poussée?
Plus de raisonnement veut dire plus de jetons de sortie et plus de temps. Les jetons de raisonnement sont des jetons de sortie : un niveau plus élevé en écrit davantage avant la réponse. Avec un plan, les longues conversations et un effort de raisonnement plus élevé consomment davantage vos fenêtres de 6 heures et hebdomadaires. Avec les crédits d'API, DCode paie aux prix par jeton de l'API, et le raisonnement est facturé au prix en sortie :
Prix de l'API par million de jetonsDollars US
| Modèle et tarif | Dollars US |
|---|---|
| Raven Max, sortie | 6,25 |
| Raven Flash, sortie | 2,50 |
| Raven Max, entrée | 1,25 |
| Raven Flash, entrée | 0,50 |
Sur les deux modèles, un jeton de sortie coûte plus cher qu'un jeton d'entrée : voilà pourquoi la réflexion vaut d'être dépensée là où elle compte. Notre article sur le coût d'une tâche d'IA calcule de vraies tâches au cent près, raisonnement compris.
Comment choisir?
Commencez à Standard. Passez à Élevé pour la partie difficile d'une tâche, et redescendez quand le travail redevient routinier. Le modèle compte autant que le niveau : Raven Max ou Raven Flash? explique lequel convient à quel travail. Le sélecteur et la barre de réflexion de la CLI sont présentés dans notre article sur la CLI DCode 2.0.
Questions et réponses
À quel niveau de raisonnement DCode commence-t-il?
Standard. Un modèle que vous choisissez commence à Standard, le niveau par défaut depuis DCode 2.0.3, pour un meilleur équilibre entre vitesse et profondeur. Vous pouvez changer de niveau en tout temps.
Un niveau de raisonnement plus élevé consomme-t-il davantage?
Oui. Les jetons de raisonnement sont des jetons de sortie : plus de réflexion veut dire plus de jetons de sortie et plus de temps. Avec un plan, un effort de raisonnement plus élevé consomme davantage vos fenêtres de 6 heures et hebdomadaires; avec les crédits d'API, le raisonnement est facturé au prix en sortie.
Devrais-je laisser DCode à Élevé?
Pas pour tout. Élevé en vaut la peine pour les problèmes difficiles, quand une mauvaise étape coûte plus cher que l'attente. Pour les modifications rapides et les étapes simples, Faible ou Désactivé répondent plus tôt et utilisent moins de jetons.
Première publication le Dernière mise à jour le